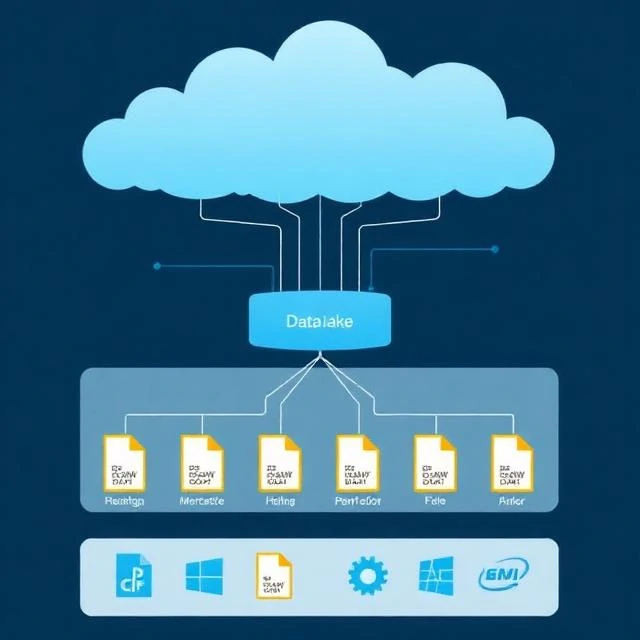
En datasø lagrer rådata i deres oprindelige format. Der kræves ikke noget skema ved skrivning. Strukturerede tabeller, JSON-logfiler, billeder og video findes alle i det samme repository. Skemaet anvendes, når dataene læses, ikke når de gemmes. Denne fleksibilitet er det, der gør det attraktivt. Datasøen accepterer alt. Den kræver ikke, at du ved, hvordan du vil bruge dataene, før du gemmer dem.
Fleksibiliteten er også problemet. Uden styring bliver en datasø til en datasump. Ingen ved, hvad der er i den. Filer har kryptiske navne. Metadata mangler. Dataene duplikeres på tværs af mapper. Analytikere kan ikke finde det, de har brug for. Dataforskere spilder tid på at rydde op og udforske i stedet for at analysere. Søen bliver et omkostningscenter, ikke et aktiv. Løsningen er styring: kataloger, metadata, adgangskontroller og klart ejerskab. Moderne data lakehouse-arkitekturer tilføjer tabelformater som Delta Lake og Iceberg, der bringer skemahåndhævelse, ACID-transaktioner og forespørgselsydeevne til søen. Søen og lageret konvergerer. Det bedste fra begge: fleksibiliteten i rå lagring og pålideligheden af strukturerede tabeller. Teknologien er forbedret. Styringskravet forbliver.
Datasøens egenskaber
- Schema-on-read — anvend struktur ved forespørgsler
- Rå lagring — data opbevares i originalt format
- Skalerbar — håndterer petabytes på commodity storage
- Fleksibel — understøtter strukturerede, semistrukturerede og ustrukturerede data
- Afhængig af styring — uden katalogisering bliver det en sump
En datasø er et reservoir. Uden et kort er det bare et vandområde.
Comments
No comments yet. Be the first to share a thought.
Leave a comment