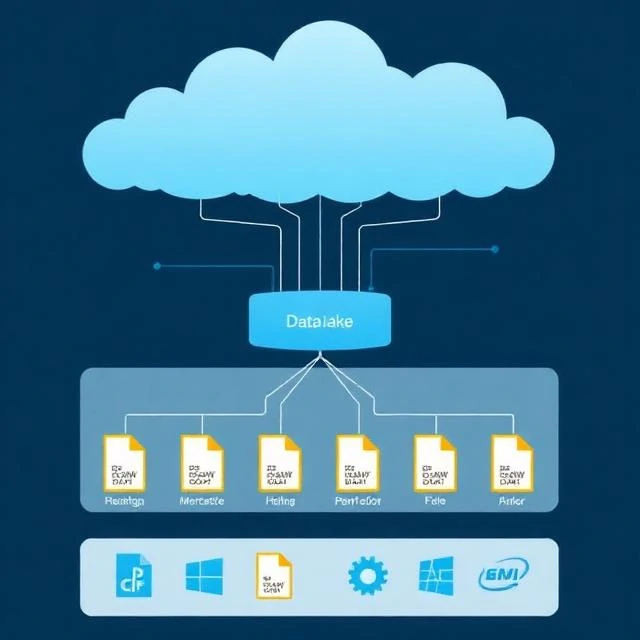
Um data lake armazena os dados em bruto no seu formato nativo. Nenhum esquema é imposto na gravação. As tabelas estruturadas, os logs JSON, as imagens e os vídeos estão todos no mesmo repositório. O esquema é aplicado quando os dados são lidos, e não quando são armazenados. Esta flexibilidade é o seu grande atrativo. O data lake aceita qualquer coisa. Não exige que saiba como utilizará os dados antes de os armazenar.
A flexibilidade também é o problema. Sem governação, um data lake transforma-se num pântano de dados. Ninguém sabe o que está nele. Os ficheiros têm nomes enigmáticos. Faltam metadados. Os dados estão duplicados em várias pastas. Os analistas não conseguem encontrar o que precisam. Os cientistas de dados perdem tempo a limpar e a explorar em vez de analisar. O data lake torna-se um centro de custos, não um ativo. A solução é a governação: catálogos, metadados, controlos de acesso e propriedade clara. As arquiteturas modernas de data lakehouse adicionam formatos de tabela como Delta Lake e Iceberg, que trazem a aplicação de esquemas, transações ACID e desempenho de consulta para o data lake. O data lake e o data warehouse convergem. O melhor dos dois mundos: a flexibilidade do armazenamento em bruto e a fiabilidade das tabelas estruturadas. A tecnologia melhorou. A necessidade de governação mantém-se.
Características do lago de dados
- Esquema na leitura — aplicar estrutura ao consultar
- Armazenamento bruto — dados mantidos no formato original.
- Escalável — suporta petabytes em armazenamento padrão.
- Flexível — suporta dados estruturados, semiestruturados e não estruturados.
- Dependente da governação — sem catalogação, torna-se um pântano.
Um lago de dados é um reservatório. Sem um mapa, é apenas uma massa de água.
Comments
No comments yet. Be the first to share a thought.
Leave a comment