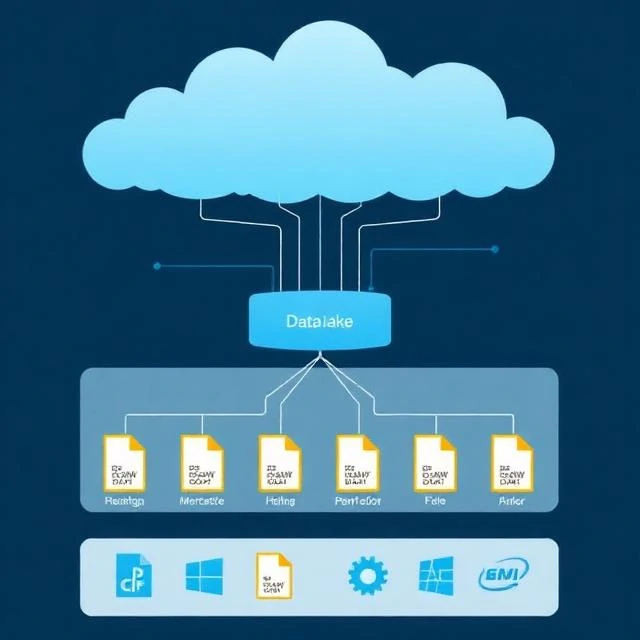
Jezioro danych przechowuje surowe dane w ich natywnym formacie. Żaden schemat nie jest wymuszany przy zapisie. Ustrukturyzowane tabele, logi JSON, obrazy i wideo znajdują się w tym samym repozytorium. Schemat jest stosowany podczas odczytu danych, a nie podczas ich zapisywania. Ta elastyczność jest zaletą. Jezioro danych akceptuje wszystko. Nie wymaga od użytkownika wiedzy o sposobie wykorzystania danych przed ich zapisaniem.
Problemem jest również elastyczność. Bez zarządzania jezioro danych staje się bagnem danych. Nikt nie wie, co się w nim znajduje. Pliki mają tajemnicze nazwy. Brakuje metadanych. Dane są duplikowane w różnych folderach. Analitycy nie mogą znaleźć tego, czego potrzebują. Analitycy danych tracą czas na czyszczenie i eksplorację zamiast na analizę. Jezioro staje się centrum kosztów, a nie zasobem. Rozwiązaniem jest zarządzanie: katalogi, metadane, kontrola dostępu i jasne zasady własności. Nowoczesne architektury data lakehouse dodają formaty tabel, takie jak Delta Lake i Iceberg, które zapewniają egzekwowanie schematu, transakcje ACID i wydajność zapytań w jeziorze. Jezioro i magazyn danych stają się zbieżne. To, co najlepsze z obu: elastyczność surowego przechowywania danych i niezawodność ustrukturyzowanych tabel. Technologia uległa poprawie. Wymóg zarządzania pozostaje.
Charakterystyka jeziora danych
- Schemat odczytu — zastosuj strukturę podczas wykonywania zapytania
- Surowe przechowywanie — dane przechowywane w oryginalnym formacie
- Skalowalny — obsługuje petabajty w pamięci masowej
- Elastyczny — obsługuje dane ustrukturyzowane, półustrukturyzowane i nieustrukturyzowane
- Zależne od zarządzania — bez katalogowania staje się bagnem
Jezioro danych to zbiornik. Bez mapy jest po prostu zbiornikiem wodnym.
Comments
No comments yet. Be the first to share a thought.
Leave a comment