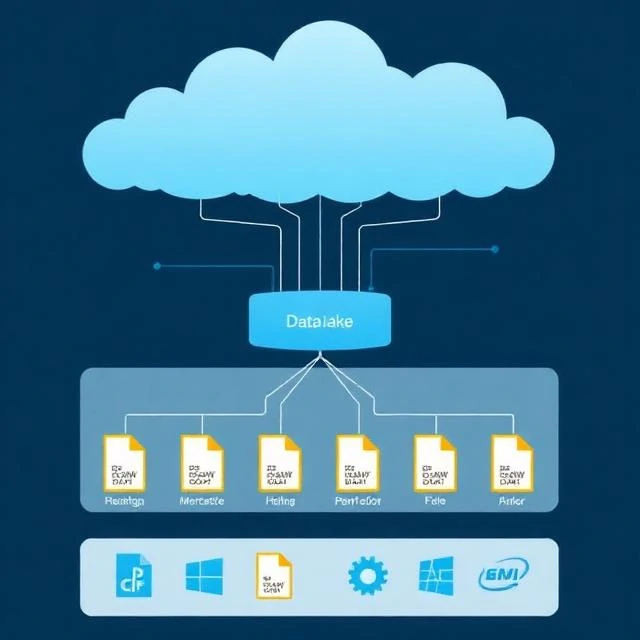
Un lago de datos almacena datos sin procesar en su formato nativo. No se aplica ningún esquema al escribir. Tablas estructuradas, registros JSON, imágenes y videos se encuentran en el mismo repositorio. El esquema se aplica al leer los datos, no al almacenarlos. Esa flexibilidad es su principal atractivo. El lago de datos acepta cualquier tipo de datos. No requiere que sepas cómo los usarás antes de almacenarlos.
La flexibilidad también es el problema. Sin gobernanza, un lago de datos se convierte en un pantano de datos. Nadie sabe qué contiene. Los archivos tienen nombres crípticos. Faltan metadatos. Los datos se duplican en carpetas. Los analistas no pueden encontrar lo que necesitan. Los científicos de datos pierden tiempo limpiando y explorando en lugar de analizando. El lago se convierte en un centro de costos, no en un activo. La solución es la gobernanza: catálogos, metadatos, controles de acceso y propiedad clara. Las arquitecturas modernas de data lakehouse añaden formatos de tabla como Delta Lake e Iceberg que aportan cumplimiento de esquema, transacciones ACID y rendimiento de consultas al lago. El lago y el almacén convergen. Lo mejor de ambos: la flexibilidad del almacenamiento sin procesar y la fiabilidad de las tablas estructuradas. La tecnología ha mejorado. El requisito de gobernanza persiste.
Características del lago de datos
- Esquema en lectura: aplicar estructura al realizar consultas.
- Almacenamiento sin procesar: datos conservados en su formato original.
- Escalable: maneja petabytes en almacenamiento estándar.
- Flexible: admite datos estructurados, semiestructurados y no estructurados.
- Depende de la gobernanza; sin catalogación, se convierte en un pantano.
Un lago de datos es un depósito. Sin un mapa, es solo una masa de agua.
Comments
No comments yet. Be the first to share a thought.
Leave a comment