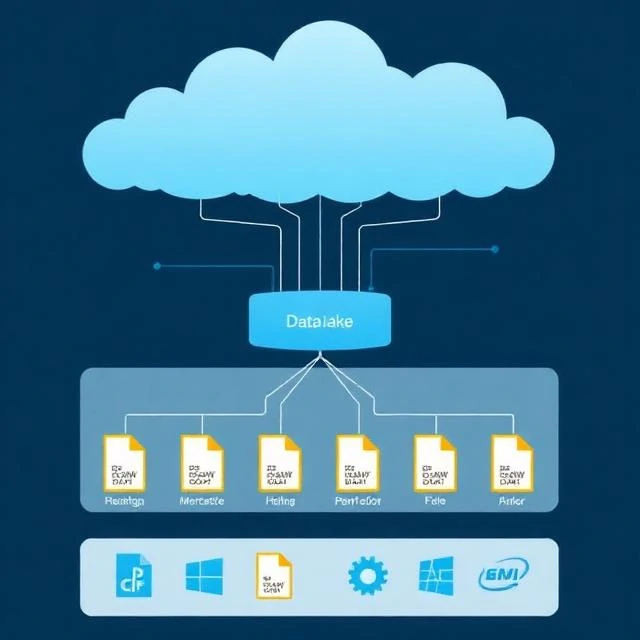
डेटा लेक में रॉ डेटा उसके मूल स्वरूप में संग्रहित होता है। लिखने पर कोई स्कीमा लागू नहीं होता। संरचित टेबल, JSON लॉग, इमेज और वीडियो सभी एक ही रिपॉजिटरी में मौजूद होते हैं। स्कीमा डेटा को पढ़ते समय लागू होता है, न कि संग्रहित करते समय। यही लचीलापन इसकी खासियत है। डेटा लेक किसी भी प्रकार का डेटा स्वीकार करता है। इसमें डेटा को संग्रहित करने से पहले यह जानना आवश्यक नहीं है कि आप उसका उपयोग कैसे करेंगे।
लचीलापन ही समस्या है। गवर्नेंस के बिना, डेटा लेक एक डेटा दलदल बन जाता है। किसी को नहीं पता होता कि उसमें क्या है। फाइलों के नाम अस्पष्ट होते हैं। मेटाडेटा गायब होता है। डेटा कई फोल्डरों में डुप्लिकेट हो जाता है। विश्लेषक अपनी ज़रूरत की चीज़ें नहीं ढूंढ पाते। डेटा वैज्ञानिक विश्लेषण करने के बजाय सफाई और खोज में समय बर्बाद करते हैं। लेक एक लागत केंद्र बन जाता है, संपत्ति नहीं। इसका समाधान गवर्नेंस है: कैटलॉग, मेटाडेटा, एक्सेस कंट्रोल और स्पष्ट स्वामित्व। आधुनिक डेटा लेकहाउस आर्किटेक्चर डेल्टा लेक और आइसबर्ग जैसे टेबल फॉर्मेट जोड़ते हैं जो लेक में स्कीमा एन्फोर्समेंट, ACID ट्रांजैक्शन और क्वेरी परफॉर्मेंस लाते हैं। लेक और वेयरहाउस एक हो जाते हैं। दोनों का सर्वोत्तम लाभ: रॉ स्टोरेज का लचीलापन और संरचित तालिकाओं की विश्वसनीयता। तकनीक में सुधार हुआ है। गवर्नेंस की आवश्यकता बनी हुई है।
डेटा लेक की विशेषताएं
- स्कीमा-ऑन-रीड — क्वेरी करते समय संरचना लागू करें
- मूल स्वरूप में संग्रहित डेटा
- स्केलेबल — सामान्य स्टोरेज पर पेटबाइट्स डेटा को संभाल सकता है
- लचीला — संरचित, अर्ध-संरचित और असंरचित डेटा का समर्थन करता है
- शासन पर निर्भर — बिना सूचीकरण के, यह दलदल बन जाता है
डेटा लेक एक जलाशय की तरह होता है। मानचित्र के बिना, यह केवल पानी का एक निकाय है।
Comments
No comments yet. Be the first to share a thought.
Leave a comment