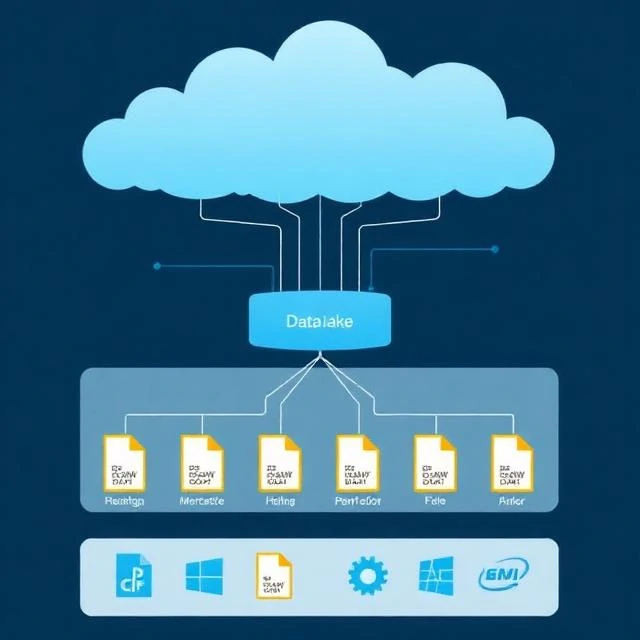
Datové jezero ukládá nezpracovaná data v jejich nativním formátu. Při zápisu se nevynucuje žádné schéma. Strukturované tabulky, protokoly JSON, obrázky a videa jsou uloženy ve stejném repozitáři. Schéma se aplikuje při čtení dat, nikoli při jejich ukládání. Právě tato flexibilita je jeho lákadlem. Datové jezero akceptuje cokoli. Nevyžaduje, abyste před uložením dat věděli, jak je použijete.
Problémem je také flexibilita. Bez správy a řízení dat se datové jezero stává datovým močálem. Nikdo neví, co v něm je. Soubory mají záhadné názvy. Chybí metadata. Data jsou duplikována napříč složkami. Analytici nemohou najít to, co potřebují. Datoví vědci ztrácejí čas čištěním a zkoumáním místo analýzy. Datové jezero se stává nákladovým střediskem, nikoli aktivem. Řešením je správa a řízení: katalogy, metadata, řízení přístupu a jasné vlastnictví. Moderní architektury datových jezer přidávají formáty tabulek, jako je Delta Lake a Iceberg, které do jezera přinášejí vynucování schémat, transakce ACID a výkon dotazů. Jezero a datový sklad se sbližují. To nejlepší z obojího: flexibilita úložiště raw a spolehlivost strukturovaných tabulek. Technologie se zlepšila. Požadavek na správu a řízení zůstává.
Charakteristiky datového jezera
- Schéma při čtení – použití struktury při dotazování
- Raw storage – data uchovávaná v původním formátu
- Škálovatelné – zvládá petabajty na komoditním úložišti
- Flexibilní – podporuje strukturovaná, polostrukturovaná a nestrukturovaná data
- Závislé na správě věcí veřejných – bez katalogizace se to stává bažinou
Datové jezero je rezervoár. Bez mapy je to jen vodní plocha.
Comments
No comments yet. Be the first to share a thought.
Leave a comment