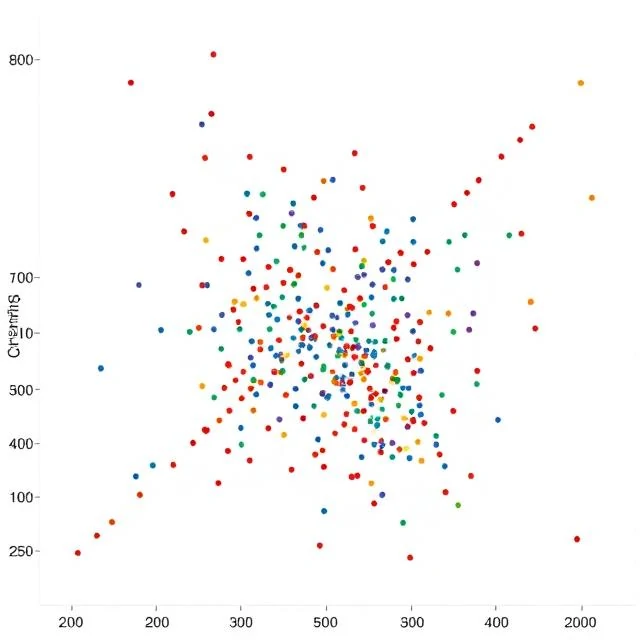
Nimeni nu etichetează datele. Clusterizarea caută grupări naturale în cadrul unui set de date, punând puncte similare împreună și separând cele diferite. Este învățare nesupravegheată în forma sa cea mai pură și se manifestă în segmentarea clienților, compresia imaginilor și detectarea anomaliilor.
Algoritmii diferă prin modul în care definesc similaritatea și forma. K-means împarte punctele într-un număr fix de clustere sferice. Clusterizarea ierarhică construiește un arbore de grupuri imbricate. DBSCAN găsește regiuni dense și etichetează punctele rare ca zgomot.
Metode comune de clusterizare
- K-medii și k-medoide
- Grupare aglomerativă ierarhică
- DBSCAN și metode bazate pe densitate
- Modele de amestecuri gaussiene
- Clusterizare spectrală
Evaluarea clusterelor este dificilă deoarece nu există o bază reală. Scorurile siluetei și graficele de cot oferă îndrumări, dar cunoașterea domeniului decide de obicei dacă o grupare este semnificativă.
Comments
No comments yet. Be the first to share a thought.
Leave a comment