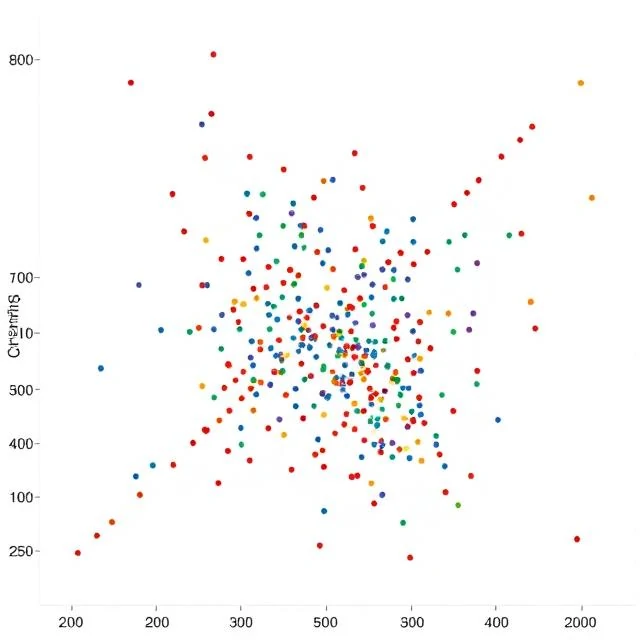
データにラベルを付ける人は誰もいません。クラスタリングはデータセット内の自然なグループ分けを探し出し、類似した点をまとめ、類似していない点を分離します。これは教師なし学習の最も純粋な形であり、顧客セグメンテーション、画像圧縮、異常検知などの分野で用いられています。
アルゴリズムによって、類似性や形状の定義方法が異なります。K平均法は、点を固定数の球状クラスターに分割します。階層的クラスタリングは、入れ子になったグループのツリー構造を構築します。DBSCANは、密な領域を検出し、疎な点をノイズとして分類します。
一般的なクラスタリング手法
- K平均法とKメドイド法
- 階層的凝集型クラスタリング
- DBSCANと密度ベースの手法
- ガウス混合モデル
- スペクトルクラスタリング
クラスタの評価は、正解となる基準が存在しないため難しい。シルエットスコアやエルボープロットは目安となるが、グループ分けが意味のあるものかどうかは、通常は専門知識に基づいて判断される。
Comments
No comments yet. Be the first to share a thought.
Leave a comment