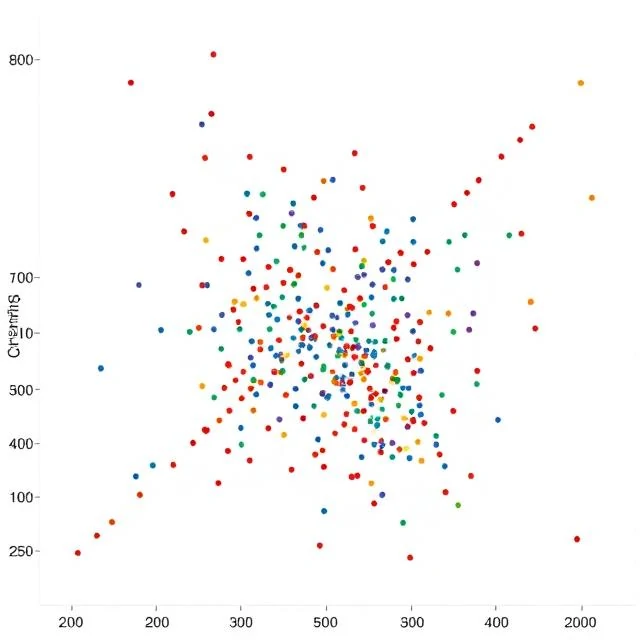
Les données ne sont pas étiquetées. Le clustering recherche des regroupements naturels au sein d'un ensemble de données, en rassemblant les points similaires et en séparant les points dissemblables. Il s'agit d'apprentissage non supervisé à l'état pur, que l'on retrouve dans la segmentation client, la compression d'images et la détection d'anomalies.
Les algorithmes diffèrent dans leur définition de la similarité et de la forme. L'algorithme K-means répartit les points en un nombre fixe de clusters sphériques. Le clustering hiérarchique construit un arbre de groupes imbriqués. DBSCAN identifie les régions denses et considère les points épars comme du bruit.
Méthodes de clustering courantes
- K-moyennes et k-médoïdes
- Classification hiérarchique agglomérative
- DBSCAN et méthodes basées sur la densité
- Modèles de mélange gaussien
- Regroupement spectral
L'évaluation des regroupements est complexe en raison de l'absence de données de référence. Les scores de silhouette et les graphiques en coude fournissent des indications, mais c'est généralement la connaissance du domaine qui détermine la pertinence d'un regroupement.
Comments
No comments yet. Be the first to share a thought.
Leave a comment