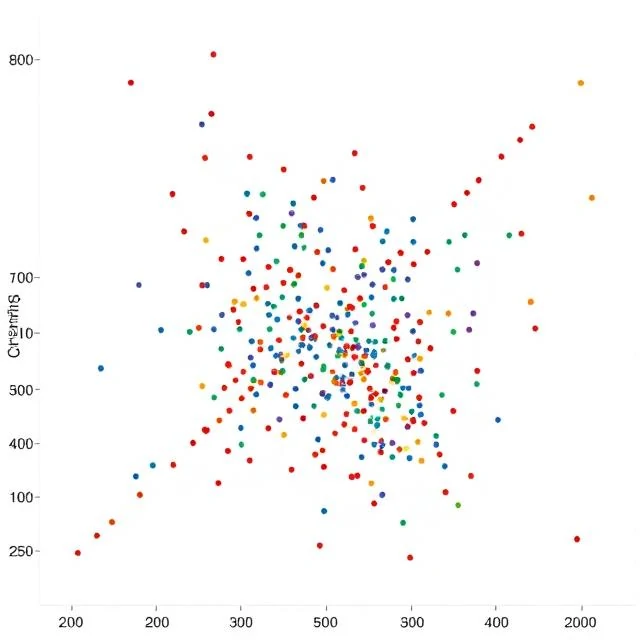
Die Daten werden nicht beschriftet. Clustering sucht nach natürlichen Gruppierungen innerhalb eines Datensatzes, indem ähnliche Punkte zusammengefasst und unähnliche getrennt werden. Es handelt sich um unüberwachtes Lernen in seiner reinsten Form, das beispielsweise bei der Kundensegmentierung, der Bildkomprimierung und der Anomalieerkennung Anwendung findet.
Algorithmen unterscheiden sich in der Definition von Ähnlichkeit und Form. K-Means teilt Punkte in eine feste Anzahl sphärischer Cluster auf. Hierarchisches Clustering erstellt einen Baum verschachtelter Gruppen. DBSCAN findet dichte Bereiche und kennzeichnet spärliche Punkte als Rauschen.
Gängige Clustering-Methoden
- K-Means und k-Medoids
- Hierarchisches agglomeratives Clustering
- DBSCAN und dichteabhängige Methoden
- Gaußsche Mischungsmodelle
- Spektrale Clusterung
Die Bewertung von Clustern ist schwierig, da es keine allgemeingültige Definition gibt. Silhouette-Scores und Ellbogenplots bieten zwar Anhaltspunkte, aber letztendlich entscheidet das Fachwissen darüber, ob eine Gruppierung sinnvoll ist.
Comments
No comments yet. Be the first to share a thought.
Leave a comment