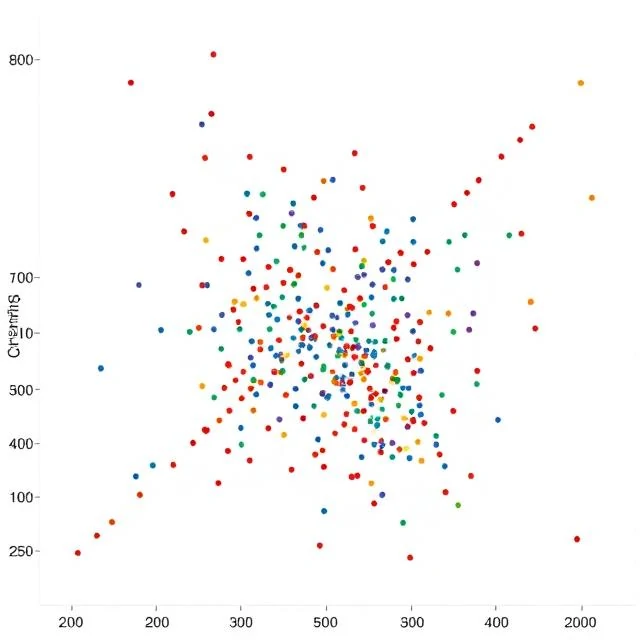
Senki sem címkézi fel az adatokat. A klaszterezés a természetes csoportosításokat keresi az adathalmazon belül, összeilleszti a hasonló pontokat, és elválasztja az eltérőket. Ez a legtisztább formájában felügyelet nélküli tanulás, és az ügyfélszegmentálásban, a képtömörítésben és az anomáliadetektálásában nyilvánul meg.
Az algoritmusok abban különböznek, hogyan definiálják a hasonlóságot és az alakot. A K-középértékek rögzített számú gömb alakú klaszterekre osztják a pontokat. A hierarchikus klaszterezés beágyazott csoportokból álló fát épít. A DBSCAN sűrű régiókat talál, és a ritka pontokat zajként jelöli.
Gyakori klaszterezési módszerek
- K-középértékek és k-medoidok
- Hierarchikus agglomeratív klaszterezés
- DBSCAN és sűrűségalapú módszerek
- Gauss-féle keverékmodellek
- Spektrális klaszterezés
A klaszterek értékelése bonyolult, mivel nincs egyetlen igazság. A sziluettpontszámok és a könyökdiagramok útmutatást nyújtanak, de a területi ismeretek általában eldöntik, hogy egy csoportosítás értelmes-e.
Comments
No comments yet. Be the first to share a thought.
Leave a comment