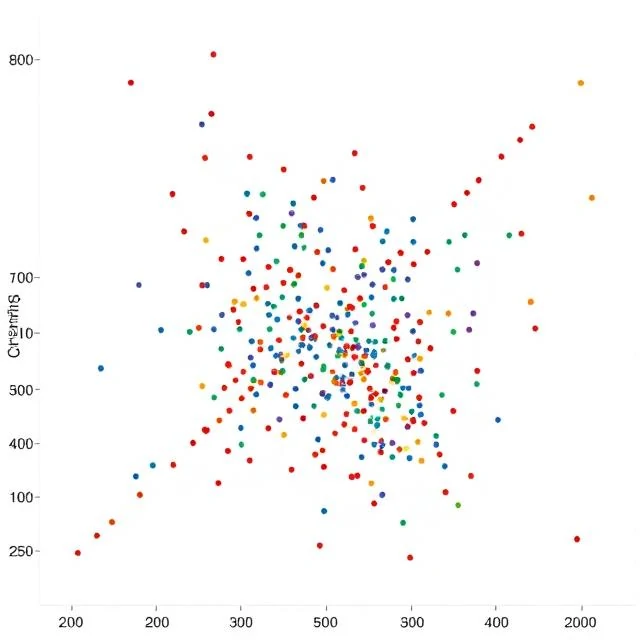
數據無需人工標註。聚類分析旨在尋找資料集中的自然分組,將相似的資料點歸為一類,將不相似的資料點分開。它是最純粹的無監督學習形式,廣泛應用於客戶區隔、影像壓縮和異常檢測等領域。
不同的演算法對相似性和形狀的定義各不相同。 K均值演算法將點分割成固定數量的球形簇。層次聚類建構一個嵌套的群組樹。 DBSCAN演算法找到密集區域並將稀疏點標記為雜訊。
常用聚類方法
- K均值和k中心點
- 層次凝聚聚類
- DBSCAN 和基於密度的方法
- 高斯混合模型
- 譜聚類
評估聚類結果很棘手,因為沒有標準答案。輪廓係數和肘部圖可以提供一些指導,但通常需要領域知識來判斷分組是否有意義。
Comments
No comments yet. Be the first to share a thought.
Leave a comment