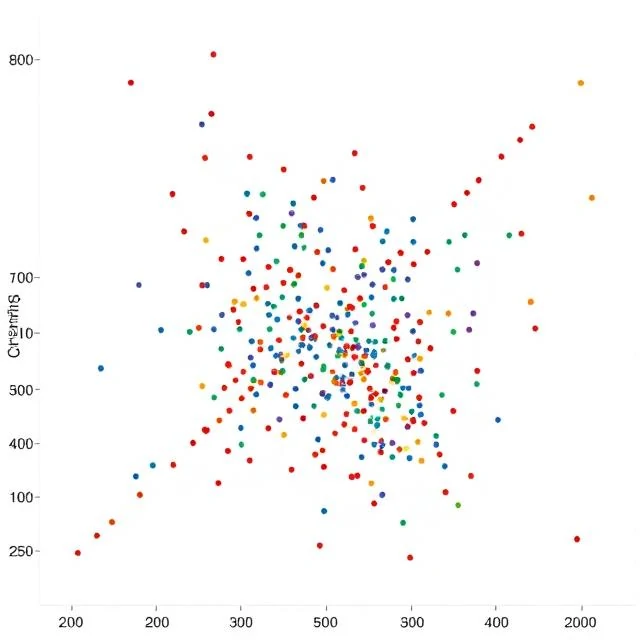
डेटा को कोई लेबल नहीं दिया जाता। क्लस्टरिंग डेटासेट के भीतर प्राकृतिक समूहों की खोज करती है, समान बिंदुओं को एक साथ रखती है और असमान बिंदुओं को अलग करती है। यह अपने शुद्धतम रूप में अनसुपरवाइज्ड लर्निंग है, और यह ग्राहक विभाजन, छवि संपीड़न और विसंगति पहचान में दिखाई देती है।
एल्गोरिदम समानता और आकार को परिभाषित करने के तरीके में भिन्न होते हैं। के-मीन्स बिंदुओं को निश्चित संख्या में गोलाकार समूहों में विभाजित करता है। पदानुक्रमित क्लस्टरिंग अंतर्निर्मित समूहों का एक वृक्ष बनाती है। डीबीएससीएएन सघन क्षेत्रों का पता लगाता है और विरल बिंदुओं को शोर के रूप में चिह्नित करता है।
सामान्य क्लस्टरिंग विधियाँ
- के-मीन्स और के-मेडॉइड्स
- पदानुक्रमिक समूहिक क्लस्टरिंग
- डीबीएससीएएन और घनत्व-आधारित विधियाँ
- गॉसियन मिश्रण मॉडल
- स्पेक्ट्रल क्लस्टरिंग
समूहों का मूल्यांकन करना मुश्किल है क्योंकि इसका कोई निश्चित आधार नहीं है। सिलुएट स्कोर और एल्बो प्लॉट मार्गदर्शन प्रदान करते हैं, लेकिन आमतौर पर विषय का ज्ञान ही यह तय करता है कि कोई समूह सार्थक है या नहीं।
Comments
No comments yet. Be the first to share a thought.
Leave a comment