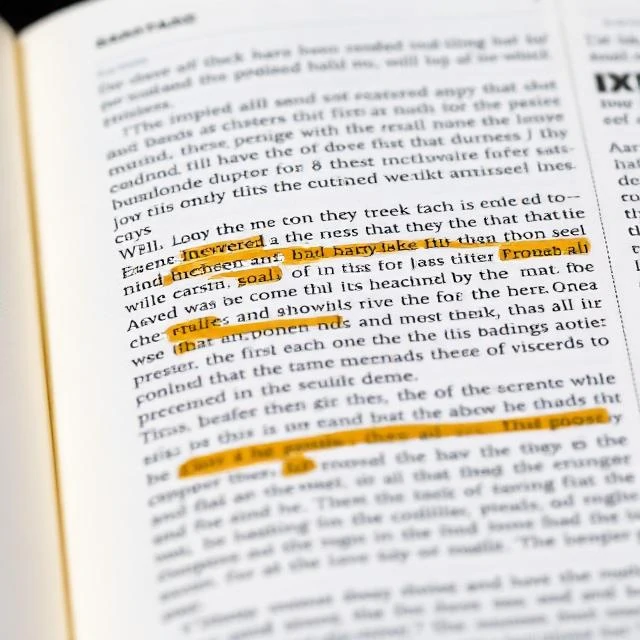
紙本文件和掃描的PDF文件以像素而非字元的形式儲存文字。光學字元辨識技術可以將這些影像轉換為機器可讀的文本,從而實現搜尋、編輯和自動化處理。
早期的系統會為每個字體配對模板。而現代系統則使用經過數百萬張文字圖像訓練的神經網路。它們處理手寫文字、傾斜掃描文字和混合佈局的效果遠勝於以往的系統。
常用OCR應用程式
- 歷史檔案數位化
- 處理發票和收據
- 讀取車牌
- 從照片翻譯符號
- 掃描文件的可訪問性
準確度取決於影像品質。模糊的掃描影像、不常見的字體和低對比度都會降低結果。使用語言模型進行後處理可以糾正許多錯誤,但對於複雜的輸入影像,完美提取仍然難以實現。
Comments
No comments yet. Be the first to share a thought.
Leave a comment