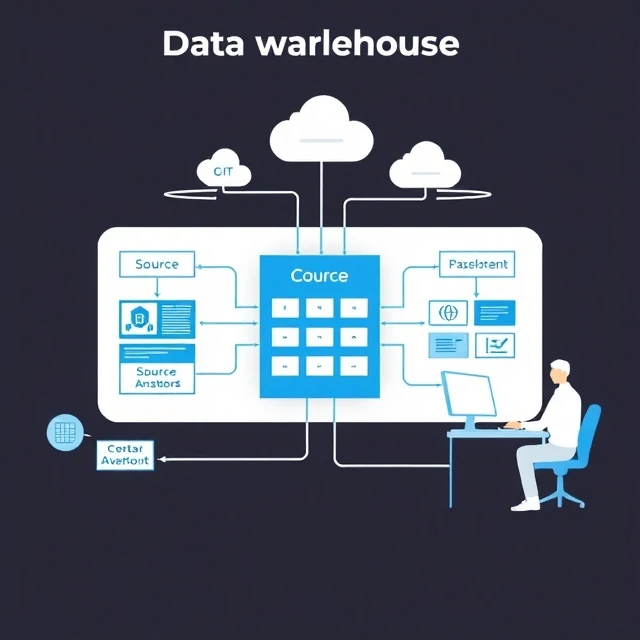
データウェアハウスは、分析のために複数のソースから統合されたデータを格納します。これは本番データベースではありません。本番システムはビジネスの運営を担います。ウェアハウスはレポート作成と意思決定をサポートします。データは、ETLまたはELTパイプラインを介してソースシステムからウェアハウスに流れ込みます。ウェアハウスは、データをクレンジング、変換、整理し、クエリに最適化されたスキーマに変換します。アナリストやビジネスインテリジェンスツールは、本番システムではなくウェアハウスに対してクエリを実行します。
アーキテクチャはワークロードを分離します。本番データベースで負荷の高い分析クエリを実行すると、顧客が使用するアプリケーションの速度が低下します。データウェアハウスはその負荷を分離します。また、データを統合します。顧客の注文、サポートチケット、Webアクティビティは異なるシステムに保存されています。データウェアハウスはそれらを統合します。この統合されたビューから洞察が得られます。従来のデータウェアハウスは、Teradata、Oracle、IBMの専用アプライアンスで稼働していました。Snowflake、BigQuery、Redshiftなどのクラウドウェアハウスは経済性を変えました。ストレージとコンピューティングを分離し、弾力的に拡張し、使用量に応じて課金します。参入障壁は下がりました。かつては多額の設備投資が必要だったデータウェアハウス機能を、小規模企業でも利用できるようになりました。テクノロジーは変化しましたが、目的は変わりません。分析のために統合データを保存することです。
倉庫の特徴
- 主題指向型 ― ビジネス領域を中心に構成されている
- 統合型 — 複数のソースからのデータを組み合わせる
- 時間変動型 — 履歴データを保持
- 不揮発性 — データはロードおよび読み取りされるが、その場で更新されない。
- クエリに最適化 - インデックス、パーティション、カラム型ストレージ
倉庫は図書館のようなものだ。ソースシステムは著者であり、アナリストは読者である。倉庫はコレクションを整理する役割を担う。
Comments
No comments yet. Be the first to share a thought.
Leave a comment