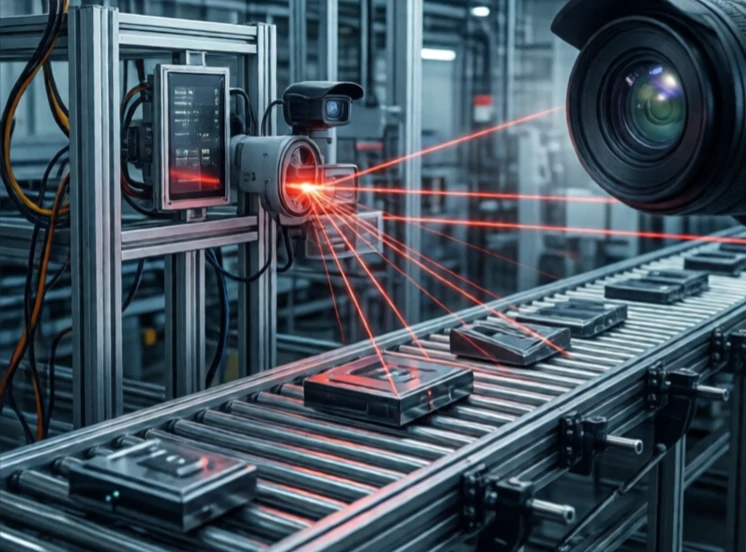
電腦視覺賦予機器人解讀視覺訊息的能力。相機捕捉影像,演算法擷取影像意義:邊緣、形狀、物體、人臉、運動等。機器人利用這些資訊進行導航、抓取、檢查或追蹤。
早期的電腦視覺依賴於手工編寫的規則:尋找邊緣、匹配模板、測量距離。它在受控光照條件下有效,但在其他情況下則失效。深度學習改變了這一切。卷積神經網路從標記影像中學習特徵。它們無需被告知要尋找什麼,就能辨識出貓咪、焊接裂紋或成熟的草莓。
電腦視覺能夠實現什麼
- 目標檢測與分類。
- 用於抓取的姿態估計。
- 採用視覺伺服進行精確對準。
- 生產製造中的缺陷檢測。
- 同步定位與建圖(SLAM)。
視覺之所以困難,是因為現實世界紛雜。光線會變化,物體會重疊,反射也會幹擾相機。在實驗室裡視覺效果良好的機器人,在工廠車間可能無法正常運作。工程師使用多個攝影機、結構光和深度感測器來增強機器人的穩健性。他們還會利用真實環境中的資料進行訓練,而不僅僅是使用乾淨的資料集。電腦視覺之所以成為機器人領域最活躍的研究方向,原因就在於此。如果機器人能夠“看”,它幾乎可以完成任何任務。如果不能,它就只能進行盲目的、重複的動作。
Comments
No comments yet. Be the first to share a thought.
Leave a comment