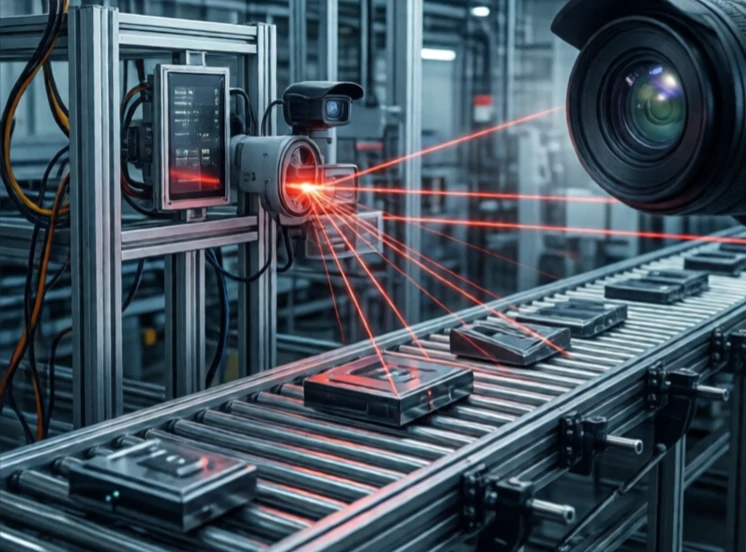
La vision par ordinateur permet aux robots d'interpréter les informations visuelles. Des caméras capturent des images. Des algorithmes en extraient le sens : contours, formes, objets, visages, mouvements. Le robot utilise ce sens pour naviguer, saisir, inspecter ou suivre des objets.
Les premiers systèmes de vision par ordinateur reposaient sur des règles programmées manuellement : détection des contours, correspondance de modèles, mesure des distances. Ils fonctionnaient sous un éclairage contrôlé, mais étaient inefficaces partout ailleurs. L’apprentissage profond a changé la donne. Les réseaux neuronaux convolutifs apprennent les caractéristiques d’images annotées. Ils peuvent reconnaître un chat, une fissure dans une soudure ou une fraise mûre sans qu’on leur indique ce qu’ils doivent rechercher.
Ce que la vision par ordinateur permet
- Détection et classification d'objets.
- Estimation de la posture pour la préhension.
- Asservissement visuel pour un alignement précis.
- Détection des défauts en production.
- Localisation et cartographie simultanées (SLAM).
La vision est complexe car le monde est chaotique. La lumière change, les objets se chevauchent et les reflets perturbent les caméras. Un robot qui voit bien en laboratoire peut se révéler défaillant en production. Les ingénieurs utilisent plusieurs caméras, la lumière structurée et des capteurs de profondeur pour améliorer la robustesse du système. Ils entraînent également les robots sur des données issues de l'environnement réel, et non sur de simples jeux de données nettoyés. La vision par ordinateur est le domaine de recherche le plus actif en robotique, et ce n'est pas un hasard. Si un robot peut voir, il peut presque tout faire. S'il ne le peut pas, il est limité à des mouvements répétitifs et aveugles.
Comments
No comments yet. Be the first to share a thought.
Leave a comment