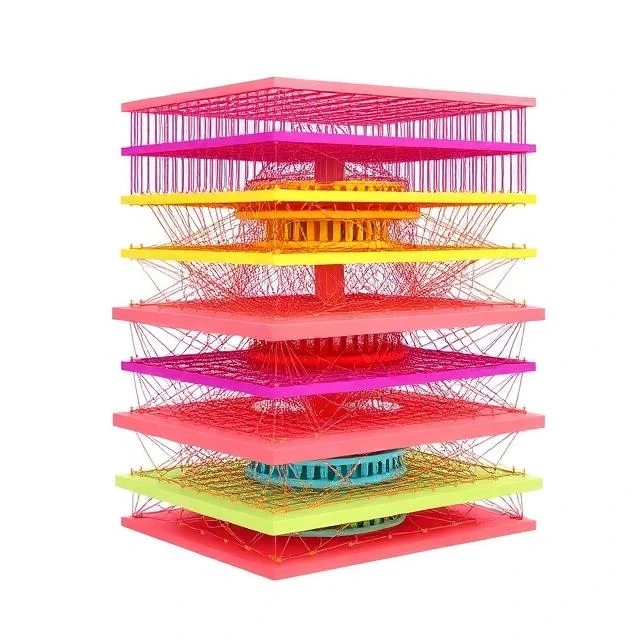
Înainte ca învățarea profundă să devină standard, antrenarea mai multor straturi simultan era dificilă. Rețelele de credințe profunde ofereau o cale de urmat prin suprapunerea mașinilor Boltzmann restricționate, antrenarea fiecărui strat cu lăcomie, apoi reglarea fină a întregului stack.
Fiecare strat învață o reprezentare a stratului inferior. Straturile superioare capturează caracteristici abstracte. Deoarece antrenamentul are loc strat cu strat, gradienții nu dispar așa cum se întâmpla în arhitecturile profunde anterioare.
Structură și instruire
- Mașini Boltzmann restricționate stivuite
- Pre-antrenament nesupravegheat strat cu strat
- Reglare fină supravegheată pe date etichetate
- Capacități generative la vârf
Rețelele DBN au avut o influență majoră la mijlocul anilor 2000 și au contribuit la renașterea interesului pentru arhitecturile profunde. Practica modernă utilizează rețele ReLU, normalizarea pe loturi și optimizatori mai buni, care se antrenează end-to-end fără abordarea greedy layerwise.
Comments
No comments yet. Be the first to share a thought.
Leave a comment