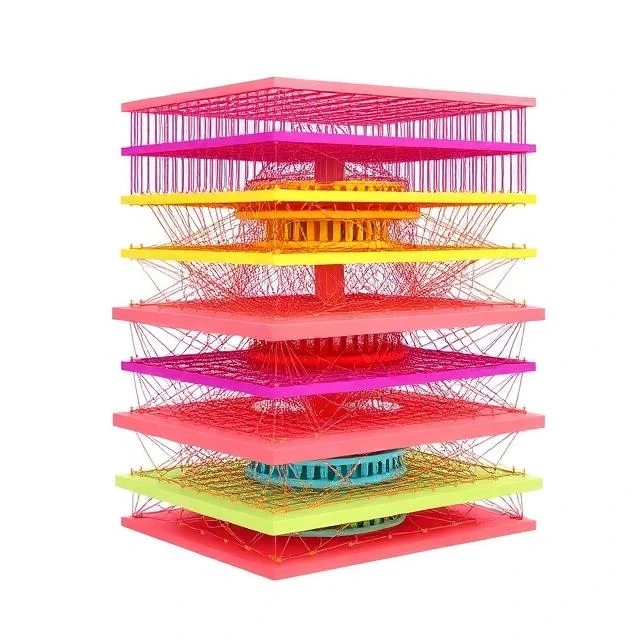
Før deep learning blev standard, var det svært at træne mange lag på én gang. Dybe trosnetværk tilbød en vej frem ved at stable begrænsede Boltzmann-maskiner, træne hvert lag grådigt og derefter finjustere hele stakken.
Hvert lag lærer en repræsentation af laget nedenunder. De øverste lag indfanger abstrakte funktioner. Fordi træning sker lag for lag, forsvinder gradienter ikke, som de gjorde i tidligere dybe arkitekturer.
Struktur og træning
- Stablede begrænsede Boltzmann-maskiner
- Uovervåget prætræning lag for lag
- Overvåget finjustering af mærkede data
- Generative evner i toppen
DBN'er var indflydelsesrige i midten af 2000'erne og hjalp med at genoplive interessen for dybe arkitekturer. Moderne praksis bruger ReLU-netværk, batchnormalisering og bedre optimeringsværktøjer, som træner end-to-end uden den grådige lagvise tilgang.
Comments
No comments yet. Be the first to share a thought.
Leave a comment