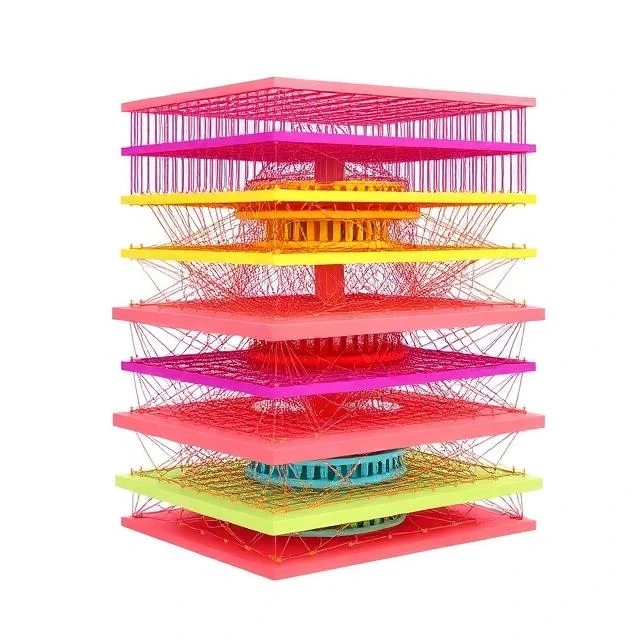
Bevor Deep Learning zum Standard wurde, war das gleichzeitige Training vieler Schichten schwierig. Deep Belief Networks boten einen Ausweg, indem sie Restricted Boltzmann Machines stapelten, jede Schicht gierig trainierten und anschließend den gesamten Stapel feinabstimmten.
Jede Schicht lernt eine Repräsentation der darunterliegenden Schicht. Die obersten Schichten erfassen abstrakte Merkmale. Da das Training schichtweise erfolgt, verschwinden Gradienten nicht wie in früheren tiefen Architekturen.
Struktur und Ausbildung
- Gestapelte eingeschränkte Boltzmann-Maschinen
- Unüberwachtes Vortraining Schicht für Schicht
- Überwachtes Feintuning auf gelabelten Daten
- Generative Fähigkeiten an der Spitze
DBNs waren Mitte der 2000er-Jahre einflussreich und trugen dazu bei, das Interesse an tiefen neuronalen Netzen neu zu entfachen. Heutzutage werden ReLU-Netzwerke, Batch-Normalisierung und verbesserte Optimierer eingesetzt, die ein durchgängiges Training ermöglichen, ohne den gierigen, schichtweisen Ansatz.
Comments
No comments yet. Be the first to share a thought.
Leave a comment