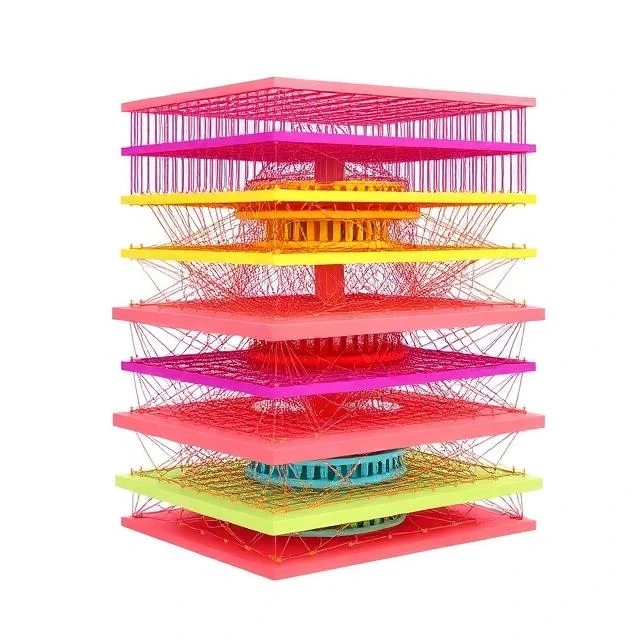
Innan djupinlärning blev standard var det svårt att träna många lager samtidigt. Djupa trosnätverk erbjöd en väg framåt genom att stapla begränsade Boltzmann-maskiner, träna varje lager girigt och sedan finjustera hela stacken.
Varje lager lär sig en representation av lagret under. De översta lagren fångar abstrakta funktioner. Eftersom träning sker lager för lager försvinner inte gradienter som de gjorde i tidigare djupa arkitekturer.
Struktur och utbildning
- Staplade begränsade Boltzmann-maskiner
- Oövervakad förträning lager för lager
- Övervakad finjustering av märkta data
- Generativa förmågor i toppen
DBN:er var inflytelserika i mitten av 2000-talet och hjälpte till att återuppliva intresset för djupa arkitekturer. Modern praxis använder ReLU-nätverk, batchnormalisering och bättre optimerare, som tränar från början till slut utan den giriga lagervisa metoden.
Comments
No comments yet. Be the first to share a thought.
Leave a comment