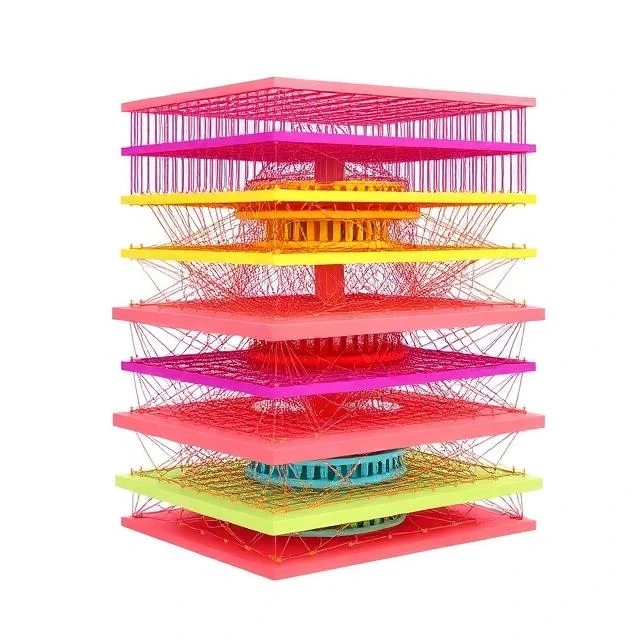
Før dyp læring ble standard, var det vanskelig å trene mange lag samtidig. Dype trosnettverk tilbød en vei videre ved å stable begrensede Boltzmann-maskiner, trene hvert lag grådig og deretter finjustere hele stakken.
Hvert lag lærer en representasjon av laget under. De øverste lagene fanger opp abstrakte funksjoner. Fordi trening skjer lag for lag, forsvinner ikke gradienter slik de gjorde i tidligere dype arkitekturer.
Struktur og opplæring
- Stablede begrensede Boltzmann-maskiner
- Uovervåket fortrening lag for lag
- Overvåket finjustering av merkede data
- Generative evner på topp
DBN-er var innflytelsesrike på midten av 2000-tallet og bidro til å gjenopplive interessen for dype arkitekturer. Moderne praksis bruker ReLU-nettverk, batch-normalisering og bedre optimaliseringsverktøy, som trener ende-til-ende uten den grådige lagvise tilnærmingen.
Comments
No comments yet. Be the first to share a thought.
Leave a comment