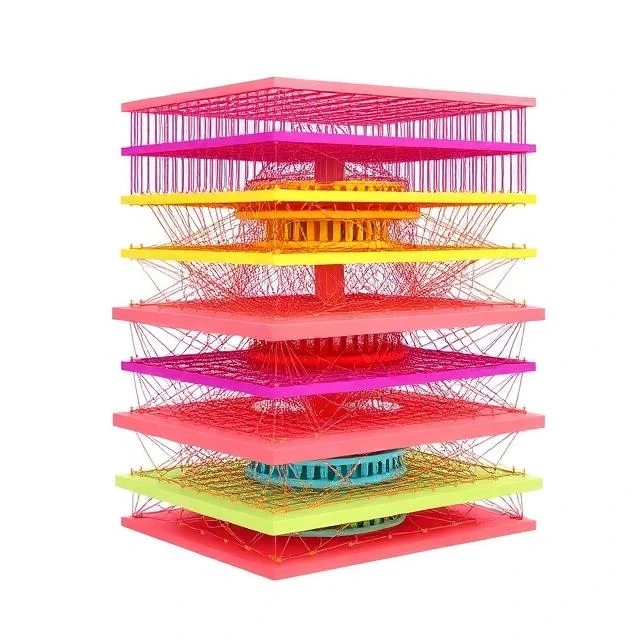
Zanim głębokie uczenie stało się standardem, trenowanie wielu warstw jednocześnie było trudne. Sieci głębokiego przekonania oferowały rozwiązanie polegające na układaniu w stosy ograniczonych maszyn Boltzmanna, trenowaniu każdej warstwy zachłannie, a następnie dostrajaniu całego stosu.
Każda warstwa uczy się reprezentacji warstwy niższej. Warstwy górne przechwytują cechy abstrakcyjne. Ponieważ trenowanie odbywa się warstwa po warstwie, gradienty nie znikają, jak miało to miejsce we wcześniejszych, głębokich architekturach.
Struktura i szkolenie
- Maszyny Boltzmanna z ograniczeniami ułożonymi w stos
- Nienadzorowane wstępne szkolenie warstwa po warstwie
- Nadzorowane dostrajanie na danych oznaczonych
- Możliwości generatywne na szczycie
Sieci DBN miały duży wpływ w połowie pierwszej dekady XXI wieku i przyczyniły się do ożywienia zainteresowania głębokimi architekturami. Współczesne praktyki wykorzystują sieci ReLU, normalizację wsadową i lepsze optymalizatory, które trenują kompleksowo, bez zachłannego podejścia warstwowego.
Comments
No comments yet. Be the first to share a thought.
Leave a comment