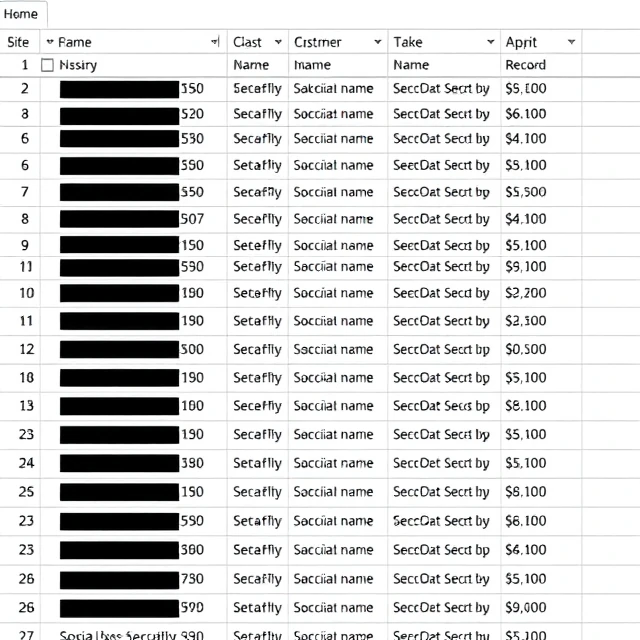
데이터 마스킹은 민감한 데이터를 가상의 값으로 대체하는 기술입니다. 실제 데이터는 운영 시스템에 그대로 유지되고, 마스킹된 데이터는 테스트 환경, 교육 또는 외부 업체에 제공됩니다. 예를 들어, 고객의 실제 사회보장번호는 동일한 유효성 검사 규칙을 통과하는 가짜 번호로 변환됩니다. 데이터 형식은 그대로 유지되지만, 값은 실제가 아닙니다. 개발자는 개인 정보를 노출하지 않고도 실제 데이터로 테스트를 진행할 수 있습니다.
마스킹에는 두 가지 형태가 있습니다. 정적 마스킹은 값을 대체하여 데이터베이스 복사본을 만드는 방식이고, 동적 마스킹은 원본 데이터를 그대로 유지하고 권한이 없는 사용자가 데이터를 조회할 때 실시간으로 마스킹하는 방식입니다. 정적 마스킹은 테스트 환경에서 더 간단하고 안전합니다. 동적 마스킹은 일부 사용자는 실제 데이터가 필요하고 다른 사용자는 필요하지 않은 운영 시스템에 유용합니다. 마스킹 기법은 다양합니다. 값 대체는 실제와 유사한 가짜 값으로 값을 바꾸는 방식이고, 셔플링은 열 내의 값 순서를 바꾸는 방식입니다. 널(Null) 처리는 값을 완전히 제거하는 방식입니다. 암호화는 키를 사용하여 데이터를 복구 가능한 방식으로 변환하는 방식이고, 토큰화는 값을 안전한 저장소에 저장된 원본 데이터에 매핑되는 토큰으로 대체하는 방식입니다. 각 기법은 현실성, 복구 가능성, 보안성 측면에서 장단점이 있습니다. 목표는 데이터 노출 위험을 제거하면서 데이터의 유용성을 유지하는 것입니다. 마스킹된 데이터는 테스트에 사용할 수 있을 만큼 실제처럼 보여야 하지만, 실제 데이터는 아니어야 합니다.
마스킹 기법
- 대체 — 현실적인 가짜 값으로 교체
- 섞기 — 열 내의 값들을 재배열합니다.
- 값을 완전히 제거 — 값을 완전히 없애다
- 토큰화 — 원본에 매핑된 토큰으로 대체
- 암호화 — 키를 이용한 가역적 변환
데이터 마스킹을 통해 조직은 위험 부담 없이 실제 데이터를 사용할 수 있습니다. 가짜 데이터가 제 역할을 하고, 실제 데이터는 안전하게 보호됩니다.
Comments (3)
Leave a comment