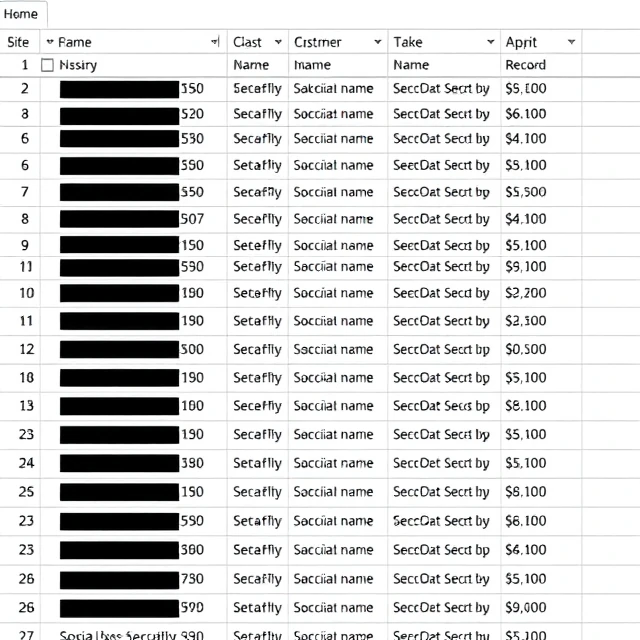
Maskování dat nahrazuje citlivá data fiktivními hodnotami. Skutečná data zůstávají v produkčním systému. Maskovaná verze se používá v testovacích prostředích, školeních nebo u externích dodavatelů. Skutečné číslo sociálního zabezpečení zákazníka se stává falešným, které prochází stejnými ověřovacími pravidly. Formát je zachován. Hodnota není skutečná. Vývojáři mohou testovat s realistickými daty, aniž by odhalili osobní údaje kohokoli.
Maskování se vyskytuje ve dvou formách. Statické maskování vytváří kopii databáze s nahrazenými hodnotami. Dynamické maskování ponechává produkční data nedotčená a maskuje je za chodu, když se na ně dotazují neoprávnění uživatelé. Statické maskování je jednodušší a bezpečnější pro testovací prostředí. Dynamické maskování je užitečné pro produkční systémy, kde někteří uživatelé potřebují skutečná data a jiní ne. Techniky se liší. Substituce nahrazuje hodnoty realistickými falešnými hodnotami. Promíchávání přeskupuje hodnoty ve sloupci. Nulování hodnotu zcela odstraní. Šifrování transformuje data reverzibilně pomocí klíče. Tokenizace nahrazuje hodnotu tokenem, který se v zabezpečeném trezoru mapuje zpět na originál. Každá z nich má kompromisy mezi realismem, reverzibilitou a bezpečností. Cílem je zachovat užitečnost dat pro jejich účel a zároveň odstranit riziko odhalení. Maskovaná data by měla vypadat dostatečně reálně, aby se dala otestovat, ale neměla by být skutečná.
Maskovací techniky
- Substituce – nahrazení realistickými falešnými hodnotami
- Míchání – změna uspořádání hodnot ve sloupci
- Nulování – úplné odstranění hodnoty
- Tokenizace – nahrazení tokenem namapovaným na originál
- Šifrování — vratná transformace s klíčem
Maskování dat umožňuje organizacím používat realistická data bez podstupování rizika. Falešná data fungují dobře. Skutečná data zůstávají chráněna.
Comments (3)
Leave a comment