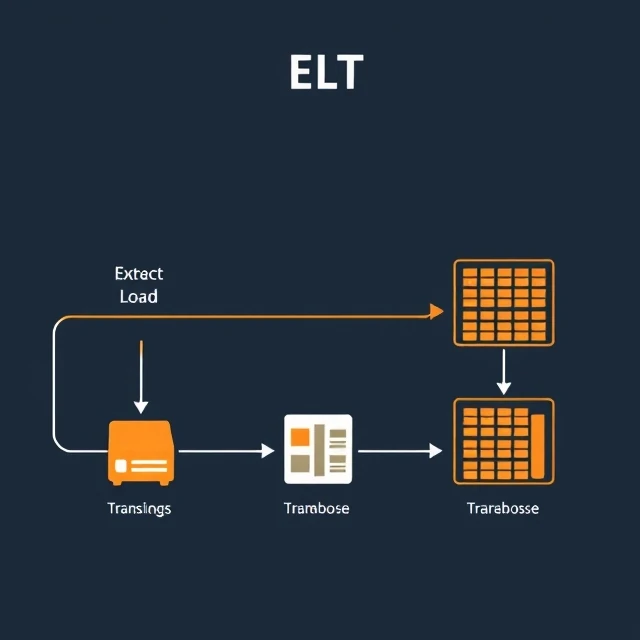
ELTは、抽出、ロード、変換の略です。従来のETLとは逆の順序で行われます。データはソースから抽出され、生データのままターゲットシステムに直接ロードされます。変換処理は、ターゲットシステム(通常はクラウドデータウェアハウス)内で、そのコンピューティング能力を利用して行われます。このアプローチは、クラウドウェアハウスの規模が拡大し、処理コストが低下するにつれて普及しました。ウェアハウスでより速く、より安価に変換できるのに、なぜ別のサーバーで変換する必要があるのでしょうか?
ELTには利点があります。生データはデータウェアハウスに保存されるため、ソースから再抽出することなく変換を再実行できます。新しい変換を遡及的に適用することも可能です。ターゲットシステムが重い処理を担うため、パイプラインアーキテクチャが簡素化されます。dbtなどのツールは、バージョン管理、テスト、ドキュメント作成、モジュール化されたコードなど、ソフトウェアエンジニアリングの手法を変換に取り入れました。トレードオフとして、データウェアハウスはストレージと変換の両方を処理できるだけの十分な能力を備えている必要があります。また、変換前に生データ、場合によっては機密データがデータウェアハウスに格納されるため、アクセス制御によって保護する必要があります。ELTはETLよりも常に優れているわけではありません。ワークロードによっては、ロード前に変換することでデータウェアハウスに到達するデータ量を削減できます。また、ELTの柔軟性が有利なワークロードもあります。どちらを選択するかは、ターゲットシステムの機能とチームの好みによります。
ELTの特性
- 生データをロード — データは加工されずにデータウェアハウスに格納される
- その場で変換を実行 ― ウェアハウスコンピューティングが変換処理を担う
- 再処理可能 — 変換処理は生データに対して再実行できます
- パイプラインが簡素化され、可動部品が少なくなる
- 倉庫に依存する — スケーラブルなコンピューティングが必要
ELTはETLを逆転させたものだ。データウェアハウスが処理を行い、パイプラインは単にデータを移動させるだけだ。
Comments
No comments yet. Be the first to share a thought.
Leave a comment