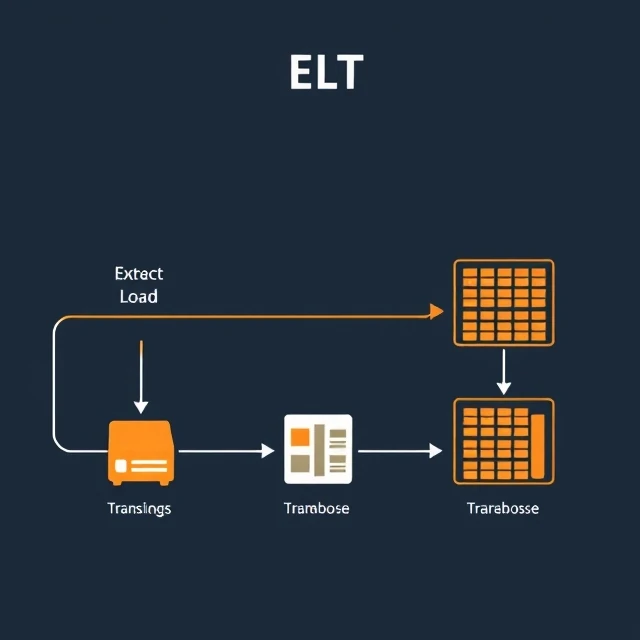
ELT steht für Extrahieren, Laden und Transformieren. Es kehrt die traditionelle ETL-Reihenfolge um. Daten werden aus den Quellen extrahiert und direkt im Rohformat in das Zielsystem geladen. Die Transformationen erfolgen innerhalb des Zielsystems, üblicherweise eines Cloud-Data-Warehouses, unter Nutzung dessen Rechenleistung. Dieser Ansatz gewann an Popularität, als Cloud-Warehouses skalierten und ihre Verarbeitungskosten sanken. Warum auf einem separaten Server transformieren, wenn das Data-Warehouse dies schneller und kostengünstiger erledigen kann?
ELT bietet Vorteile. Die Rohdaten bleiben im Data Warehouse erhalten, sodass Transformationen wiederholt werden können, ohne die Daten erneut aus den Quellen extrahieren zu müssen. Neue Transformationen lassen sich nachträglich anwenden. Das Zielsystem übernimmt die rechenintensiven Aufgaben, was die Pipeline-Architektur vereinfacht. Tools wie dbt haben Software-Engineering-Methoden in die Transformation integriert: Versionskontrolle, Tests, Dokumentation und modularer Code. Der Nachteil ist, dass das Data Warehouse leistungsstark genug sein muss, um sowohl Speicherung als auch Transformation zu bewältigen. Außerdem befinden sich die Rohdaten, die potenziell sensible Daten enthalten, vor der Transformation im Data Warehouse. Zugriffskontrollen müssen diese Daten schützen. ELT ist nicht generell besser als ETL. Bei manchen Workloads reduziert die Transformation vor dem Laden das Datenvolumen, das das Data Warehouse erreicht. Bei anderen Workloads ist die Flexibilität von ELT von Vorteil. Die Wahl hängt von den Fähigkeiten des Zielsystems und den Präferenzen des Teams ab.
ELT-Charakteristika
- Rohdaten laden – die Daten landen unverändert im Data Warehouse.
- Transformation direkt vor Ort – Warehouse Compute übernimmt Transformationen.
- Wiederverarbeitbar – Transformationen können auf Rohdaten erneut ausgeführt werden.
- Einfachere Rohrleitungen – weniger bewegliche Teile
- Lagerabhängig – erfordert skalierbare Rechenleistung
ELT ist im Prinzip ETL, nur umgekehrt. Das Data Warehouse erledigt die eigentliche Arbeit. Die Pipeline verschiebt lediglich die Daten.
Comments
No comments yet. Be the first to share a thought.
Leave a comment