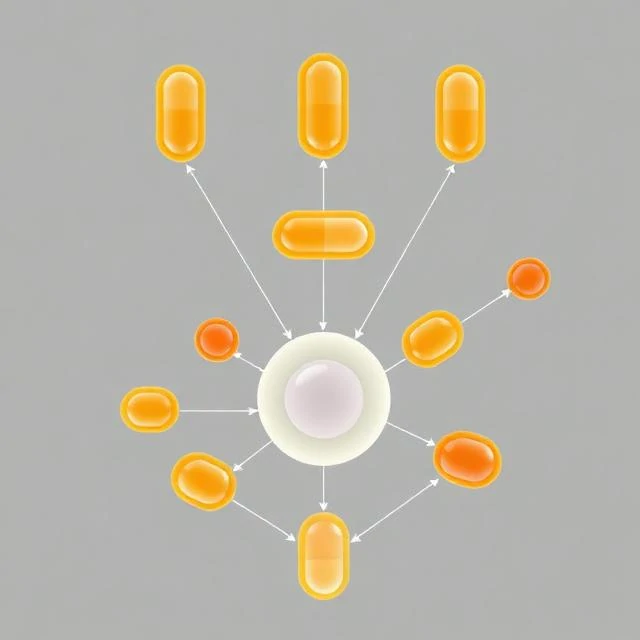
As redes convolucionais têm dificuldades com a orientação. Ao rodar um rosto, uma CNN pode até detetar o nariz, mas perde a relação espacial entre o nariz e a boca. As redes de cápsulas tentam preservar esta informação agrupando os neurónios em cápsulas que produzem vetores em vez de escalares.
Cada cápsula codifica tanto a presença de uma característica como as suas propriedades, como a pose ou a orientação. O encaminhamento dinâmico permite que as cápsulas de nível inferior enviem a sua saída para cápsulas de nível superior que concordem com as mesmas, construindo relações parte-todo.
Vantagens potenciais
- Melhor controlo da rotação e do ponto de vista.
- Preservação de hierarquias espaciais
- Menos necessidade de séries de treino enormes
- Representações internas mais interpretáveis
A adoção tem sido limitada. As redes de cápsulas têm um treino lento e não alcançaram o desempenho das CNNs em benchmarks de grande escala. Permanecem uma área de investigação ativa, em vez de um padrão de produção.
Comments
No comments yet. Be the first to share a thought.
Leave a comment