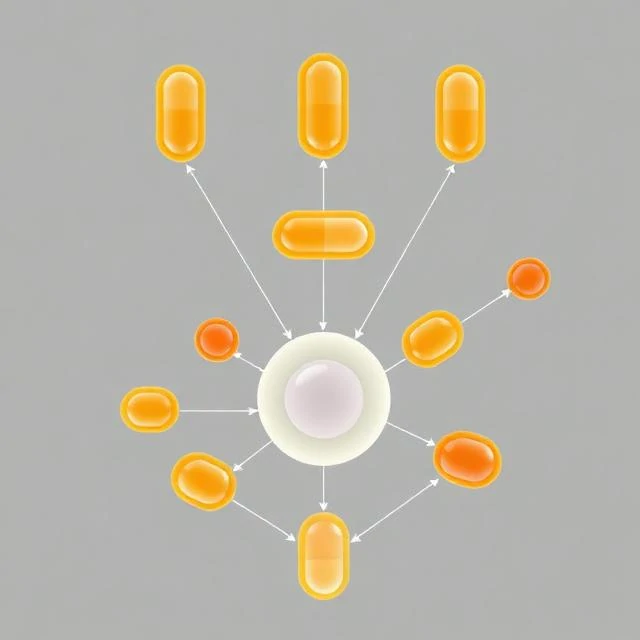
Las redes neuronales convolucionales tienen dificultades con la orientación. Si se rota un rostro, una CNN aún puede detectar la nariz, pero pierde la relación espacial entre la nariz y la boca. Las redes de cápsulas intentan preservar esa información agrupando neuronas en cápsulas que generan vectores en lugar de escalares.
Cada cápsula codifica tanto la presencia de una característica como sus propiedades, como la postura o la orientación. El enrutamiento dinámico permite que las cápsulas de nivel inferior envíen su salida a las cápsulas de nivel superior que coinciden con ellas, estableciendo relaciones de parte-todo.
Ventajas potenciales
- Mejor manejo de la rotación y el punto de vista.
- Preservación de jerarquías espaciales
- Menor necesidad de grandes conjuntos de entrenamiento
- Representaciones internas más interpretables
Su adopción ha sido limitada. Las redes de cápsulas se entrenan lentamente y no han alcanzado el rendimiento de las CNN en pruebas comparativas a gran escala. Siguen siendo una línea de investigación activa, más que un estándar de producción.
Comments
No comments yet. Be the first to share a thought.
Leave a comment