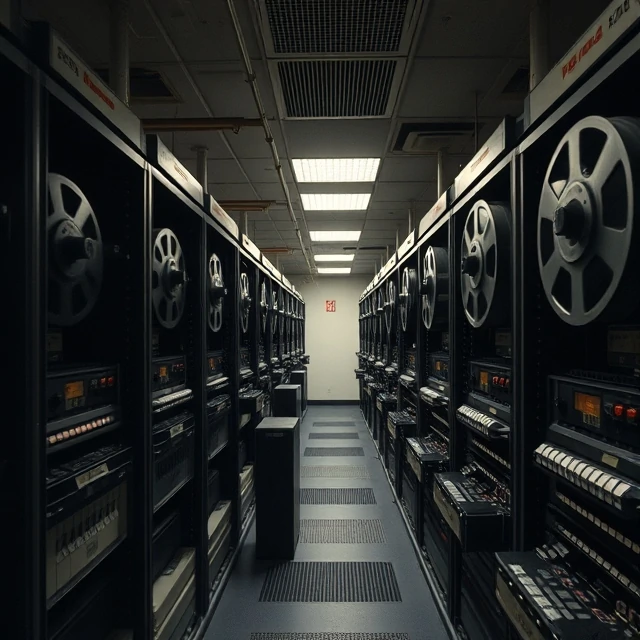
批量处理是指按预定时间批量处理大量数据。系统不会逐笔处理到达的交易,而是将它们收集起来一起处理。银行几十年来一直使用批量处理来处理隔夜支票。工资系统也通过批量处理来计算工资和扣款。当效率比及时性更重要时,这种模式非常有效。
权衡之处在于延迟。凌晨 2 点运行的批处理作业意味着前一天的数据要到第二天早上才能获取。对于工资和账单处理来说,这没问题。但对于欺诈检测或实时定价来说,就不行了。流处理通过在数据到达时进行分析来处理这些情况。许多现代架构都同时使用这两种方式。流处理处理紧急事件,批处理处理历史分析、数据核对和报告。两者相辅相成。批处理作业的运行成本也更低,因为它们可以安排在计算资源空闲的非高峰时段运行。Hadoop 和 Spark 普及了分布式集群上的大规模批处理。技术不断发展,但模式却由来已久:收集、调度、处理、交付。
批量处理特性
- 定时运行——按既定时间间隔运行,通常在夜间运行。
- 高容量——高效处理大型数据集
- 延迟容忍型——无需立即获得结果
- 资源利用效率高——利用非高峰时段的计算能力
- 确定性——相同的输入产生相同的输出
批量处理并没有过时。当吞吐量比速度更重要时,它仍然是正确的工具。
Comments
No comments yet. Be the first to share a thought.
Leave a comment