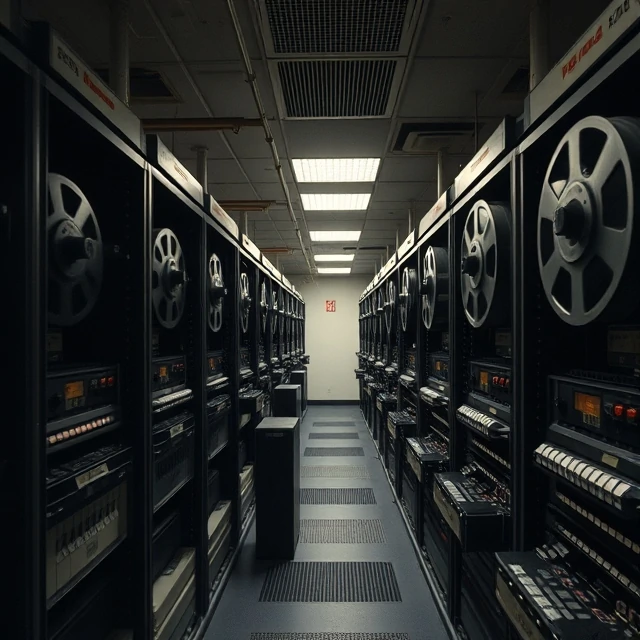
일괄 처리는 정해진 시간에 대규모 데이터 그룹을 처리합니다. 시스템이 각 거래를 도착하는 대로 처리하는 대신, 거래들을 모아서 한꺼번에 처리합니다. 은행들은 수십 년 동안 일괄 처리를 사용하여 수표를 밤새도록 처리해 왔습니다. 급여 시스템 또한 일괄 처리를 통해 임금과 공제액을 계산합니다. 이 모델은 적시성보다 효율성이 더 중요한 경우에 효과적입니다.
단점은 지연 시간입니다. 새벽 2시에 실행되는 배치 작업은 전날 데이터를 아침까지 사용할 수 없다는 것을 의미합니다. 급여 및 청구 업무에는 문제가 없지만, 사기 탐지나 실시간 가격 책정에는 적합하지 않습니다. 스트림 처리는 데이터가 도착하는 즉시 분석하여 이러한 문제를 해결합니다. 많은 최신 아키텍처에서 두 가지 방식을 모두 사용합니다. 스트리밍은 긴급한 이벤트를 처리하고, 배치는 과거 데이터 분석, 대조 및 보고를 처리합니다. 두 방식은 서로를 보완합니다. 배치 작업은 컴퓨팅 리소스가 유휴 상태인 비피크 시간대에 예약할 수 있으므로 실행 비용도 저렴합니다. Hadoop과 Spark는 분산 클러스터에서 대규모 배치 처리를 대중화했습니다. 기술은 발전했지만 기본 패턴은 오래되었습니다. 데이터를 수집하고, 예약하고, 처리하고, 전달하는 것입니다.
배치 처리 특성
- 정기 실행 — 정해진 간격으로 실행되며, 종종 야간에 실행됩니다.
- 대용량 처리 - 대규모 데이터 세트를 효율적으로 처리합니다.
- 결과 대기 시간 허용 - 결과가 즉시 필요하지 않음
- 자원 효율성 — 컴퓨팅 용량이 사용량이 적은 시간대를 활용합니다.
- 결정론적 — 동일한 입력은 동일한 출력을 생성함
배치 처리는 구식이 아닙니다. 속도보다 처리량이 더 중요할 때 적합한 도구입니다.
Comments
No comments yet. Be the first to share a thought.
Leave a comment