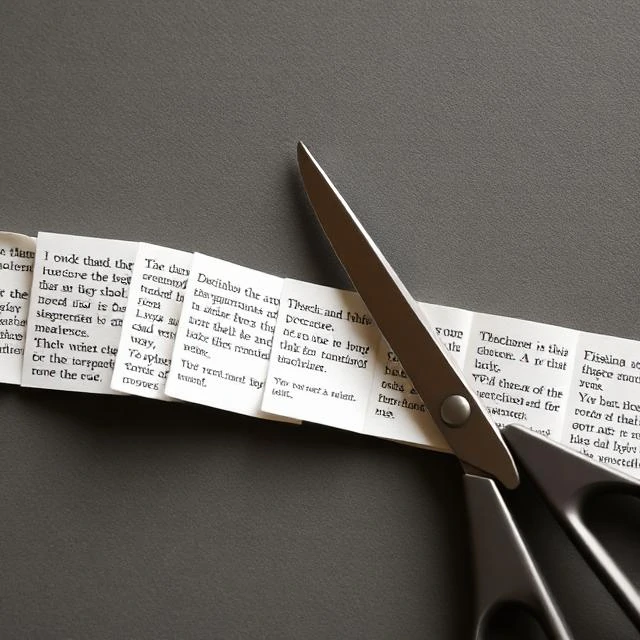
Înainte ca un model lingvistic să poată citi ceva, textul trebuie să fie împărțit în bucăți pe care le poate număra. Aceste bucăți sunt token-uri, iar tokenizarea este împărțirea. Un token poate fi un cuvânt întreg, un fragment precum „ing” sau „pre”, un semn de punctuație sau chiar un singur caracter. Modelul nu vede niciodată text brut; vede o secvență de ID-uri întregi mapate la aceste token-uri.
Scheme diferite fac compromisuri diferite. Tokenizarea la nivel de cuvânt menține sensul intact, dar explodează în milioane de cuvinte rare și se confruntă cu greșeli de scriere. Tokenizarea la nivel de caracter are un vocabular mic, dar produce secvențe foarte lungi. Metodele de subcuvinte, cum ar fi codificarea perechilor de octeți, se află la mijloc: încep cu caractere și îmbină în mod repetat cele mai frecvente perechi până când se atinge o dimensiune țintă a vocabularului.
De ce contează
- Dimensiunea vocabularului determină tabelul de încorporare al modelului și amprenta de memorie
- Numărul de tokenuri setează fereastra de context și costul fiecărui apel API
- Tokenizarea deficitară împarte cuvintele în moduri care afectează performanța multilingvă
- Limbile cu alfabet nelatin au nevoie adesea de mult mai multe jetoane per propoziție
O propoziție în engleză ar putea folosi 20 de tokenuri; aceeași propoziție în thailandeză sau hindi poate necesita 60 sau mai multe sub un tokenizator occidental. Acest dezechilibru afectează viteza, prețul și acuratețea pentru miliarde de vorbitori.
Comments
No comments yet. Be the first to share a thought.
Leave a comment