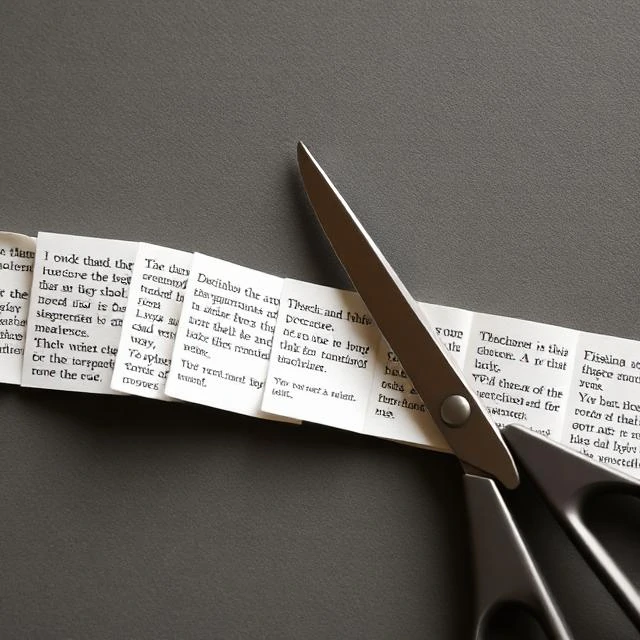
语言模型在读取任何内容之前,必须先将文本分割成可计数的片段。这些片段就是词元(token),而词元化就是分割文本的过程。一个词元可以是一个完整的单词,也可以是一个片段(例如“ing”或“pre”),一个标点符号,甚至是一个单独的字符。模型看到的永远不会是原始文本;它看到的是一串映射到这些词元的整数 ID。
不同的分词方案各有优缺点。词级分词能保持词义完整,但会产生数百万个生僻词,且难以处理拼写错误。字符级分词词汇量较小,但会产生非常长的序列。子词分词方法(例如字节对编码)则介于两者之间:它们从字符开始,反复合并最常用的字符对,直到达到目标词汇量。
为什么这很重要
- 词汇表大小决定了模型的嵌入表和内存占用。
- 令牌数量决定了上下文窗口以及每次 API 调用的成本
- 分词不当会以损害多语言性能的方式分割词语。
- 使用非拉丁字母的语言通常每句话需要更多的词符。
一个英语句子可能只需要 20 个词元;而同样的句子,如果使用以西方语言为中心的词元生成器,用泰语或印地语则可能需要 60 个甚至更多。这种不平衡影响着数十亿用户的处理速度、价格和准确性。
Comments
No comments yet. Be the first to share a thought.
Leave a comment