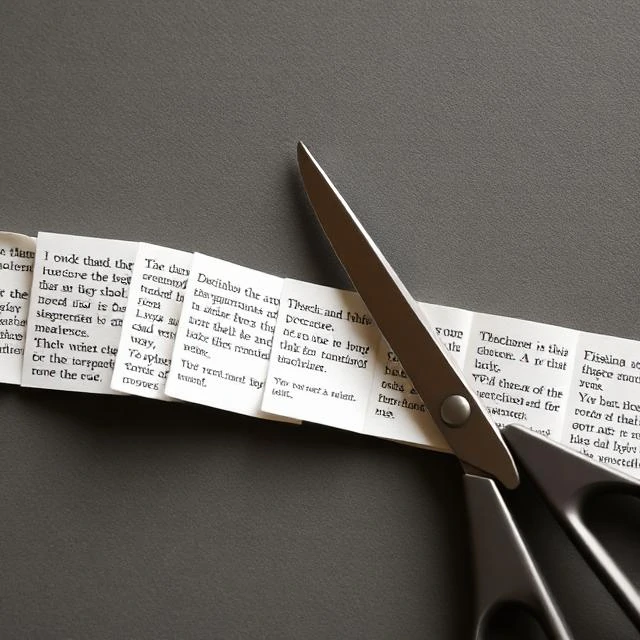
Než jazykový model dokáže cokoli přečíst, musí být text rozdělen na části, které dokáže spočítat. Tyto části jsou tokeny a tokenizace je rozdělení. Token může být celé slovo, fragment jako „ing“ nebo „pre“, interpunkční znaménko nebo dokonce jeden znak. Model nikdy nevidí surový text; vidí sekvenci celočíselných ID namapovaných na tyto tokeny.
Různá schémata přijímají různé kompromisy. Tokenizace na úrovni slov zachovává význam neporušený, ale exploduje do milionů vzácných slov a potýká se s překlepy. Tokenizace na úrovni znaků má sice malou slovní zásobu, ale produkuje velmi dlouhé sekvence. Metody podslov, jako je kódování bajtových párů, se nacházejí mezi nimi: začínají se znaky a opakovaně spojují nejčastější páry, dokud není dosaženo cílové velikosti slovní zásoby.
Proč na tom záleží
- Velikost slovní zásoby určuje vkládací tabulku a paměťovou náročnost modelu.
- Počet tokenů nastavuje kontextové okno a cenu každého volání API.
- Špatná tokenizace rozděluje slova způsobem, který negativně ovlivňuje vícejazyčný výkon.
- Jazyky s jiným písmem než latinkou často potřebují mnohem více tokenů na větu.
Věta v angličtině může použít 20 tokenů; stejná věta v thajštině nebo hindštině jich může v rámci západního tokenizátoru potřebovat 60 nebo více. Tato nerovnováha ovlivňuje rychlost, cenu a přesnost pro miliardy mluvčích.
Comments
No comments yet. Be the first to share a thought.
Leave a comment