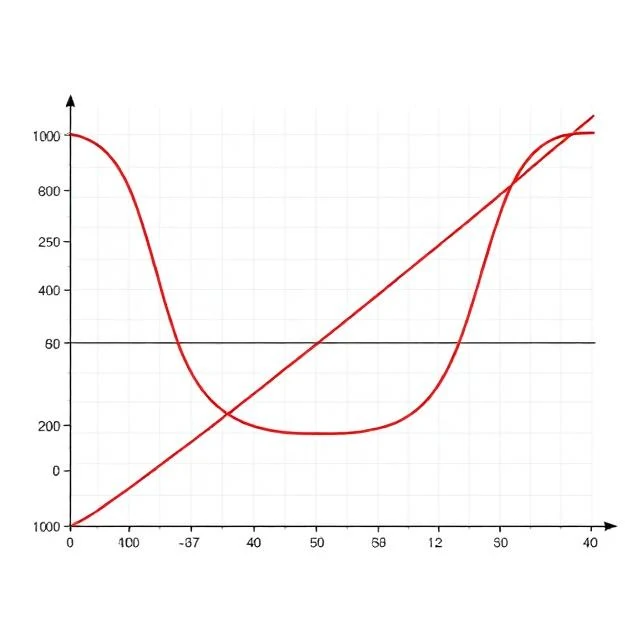
En modell som husker treningsdata feiler på nye eksempler. En modell som ignorerer nyanser, overser mønstre fullstendig. Spenningen mellom disse feilmodusene er avveiningen mellom bias og varians, og den former nesten alle beslutninger i maskinlæring.
Skjevhet måler feil fra altfor enkle antagelser. Høy skjevhet betyr undertilpasning. Varians måler følsomhet for små svingninger i treningsdata. Høy varians betyr overtilpasning. Total feil kombinerer begge deler, pluss irreduserbar støy.
Typiske signaler
- Høy treningsfeil, høy testfeil, undertilpasning
- Lav treningsfeil, høy testfeil, overtilpasning
- Både lave, godt tilpassede modeller
- Begge høye, feil modellfamilie
Moderne praksis kompliserer den klassiske kurven. Store nevrale nettverk kan oppnå lav bias og lav varians samtidig, noe eldre teori ikke forutså. Regularisering, mer data og ensemblering er fortsatt standardverktøy for å håndtere avveiningen.
Comments
No comments yet. Be the first to share a thought.
Leave a comment