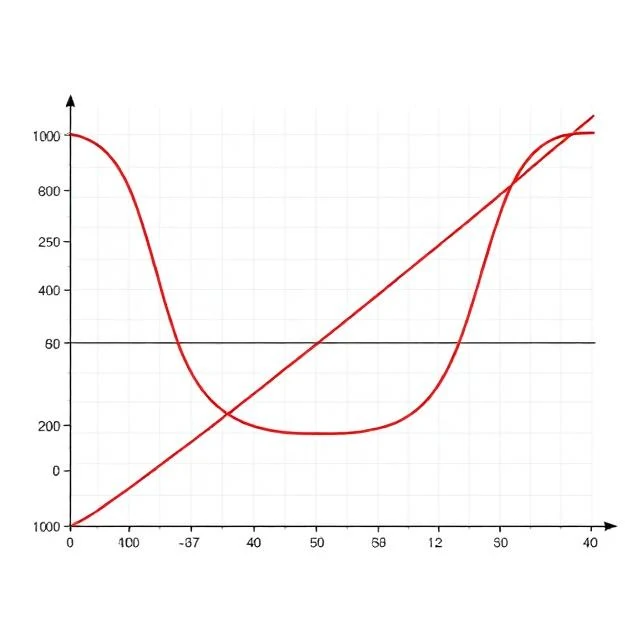
Een model dat trainingsdata uit het hoofd leert, faalt bij nieuwe voorbeelden. Een model dat nuances negeert, mist patronen volledig. De spanning tussen deze faalmodi is de bias-variantie-afweging, en deze beïnvloedt vrijwel elke beslissing in machine learning.
De bias meet de fout die voortkomt uit te simpele aannames. Een hoge bias betekent onderfitting. De variantie meet de gevoeligheid voor kleine fluctuaties in de trainingsdata. Een hoge variantie betekent overfitting. De totale fout combineert beide, plus onherleidbare ruis.
Typische signalen
- Hoge trainingsfout, hoge testfout, underfitting
- Lage trainingsfout, hoge testfout, overfitting
- Beide modellen zijn laag en goed passend.
- Beiden hoog, verkeerd model gezin
De moderne praktijk maakt de klassieke curve complexer. Grote neurale netwerken kunnen tegelijkertijd een lage bias en een lage variantie bereiken, iets wat de oudere theorie niet voorspelde. Regularisatie, meer data en ensemblemethoden blijven standaardinstrumenten om de afweging te beheersen.
Comments
No comments yet. Be the first to share a thought.
Leave a comment