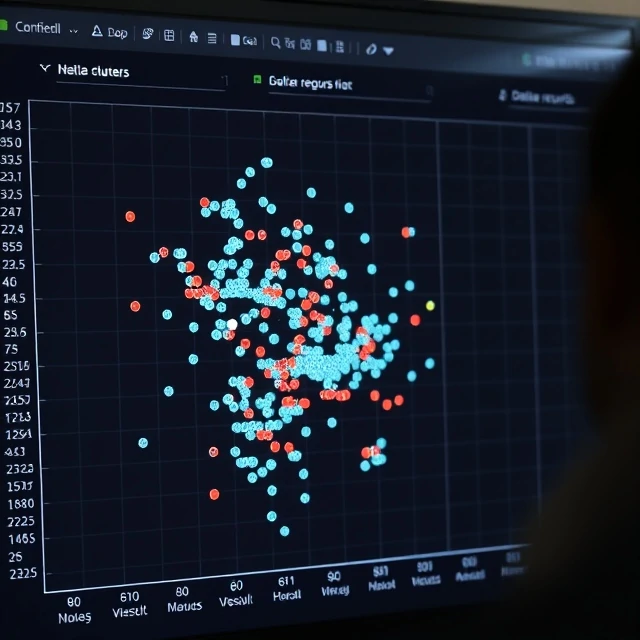
データマイニングは、大規模なデータセットからパターンを見つけ出す手法です。統計学、機械学習、データベース技術を用いて、一見分かりにくい関係性を明らかにします。例えば、ある小売店では、おむつを購入する顧客は金曜日の夜にビールも購入する傾向があることが分かります。また、ある銀行では、特定の取引パターンから不正行為を予測できることが分かります。さらに、ある病院では、再入院のリスク要因を特定できます。これらのパターンは確かに存在します。しかし、それらが有用かどうかは、どのように活用するかによって決まります。
データマイニングはデータ分析とは異なります。データ分析は仮説を検証しますが、マイニングは仮説を生成します。何を探しているのかはわかりません。アルゴリズムは相関関係と異常値を見つけます。そして、人間がどれが重要かを判断します。最後のステップが重要です。相関関係は因果関係ではありません。パターンは偽りである可能性があります。交絡変数を反映している可能性があります。データのアーティファクトである可能性があります。マイニングは結論ではなく、候補を生成します。手法には、クラスタリング、分類、回帰、アソシエーションルール、異常検出などがあります。それぞれ異なる問題に適しています。ツールは利用しやすくなりました。Pythonライブラリとクラウドサービスにより、アナリストは高度な専門知識がなくても複雑なアルゴリズムを実行できます。リスクは誤用です。1000個のモデルを実行して最良の結果を得たものを選択することは発見ではありません。それは過学習です。パターンが真であるためには、新しいデータでも維持される必要があります。
データマイニング技術
- クラスタリング — 類似するレコードをグループ化する
- 分類 — レコードをカテゴリに割り当てる
- 関連付けルール — 共起するアイテムを見つける
- 回帰分析 ― 変数間の関係をモデル化する
- 異常検知 — 異常なレコードを特定する
データマイニングはパターンを見つけ出す。その意味を解釈するのは人間だ。アルゴリズムはツールであって、神託ではない。
Comments
No comments yet. Be the first to share a thought.
Leave a comment