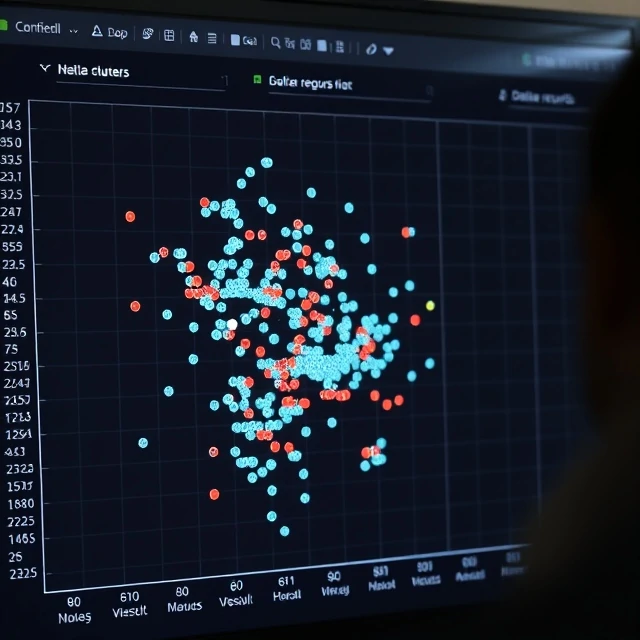
資料探勘旨在從大型資料集中發現規律。它運用統計學、機器學習和資料庫技術來揭示那些不易察覺的關聯。例如,零售商發現,購買尿布的顧客往往也會在周五晚上購買啤酒;銀行發現某些交易模式可以預測詐欺行為;醫院識別出導致患者再次入院的風險因素。這些規律是真實存在的,但它們是否有用,取決於你如何利用它們。
資料探勘與資料分析並不相同。資料分析檢驗假設,而資料探勘則產生假設。你並不知道要找什麼。演算法會發現相關性和異常值,然後由人來決定哪些相關性和異常值有意義。最後一步至關重要。相關性並不等於因果關係。某種模式可能是虛假的,可能反映了混淆變量,也可能是資料偽影。資料探勘生成的是候選結果,而不是結論。相關技術包括聚類、分類、迴歸、關聯規則和異常檢測。每種技術都適用於不同的問題。這些工具已經變得容易使用。 Python 函式庫和雲端服務讓分析人員無需深厚的專業知識即可運行複雜的演算法。風險在於誤用。運行上千個模型並選擇結果最佳的模型並非真正的發現,而是過度擬合。模式必須在新數據上仍然成立才能被認為是真實的。
資料探勘技術
- 聚類-將相似的記錄分組
- 分類-將記錄分配到對應類別
- 關聯規則-尋找同時出現的項目
- 迴歸分析-建立變數之間的關係模型
- 異常檢測-識別異常記錄
資料探勘發現模式,而人類則決定這些模式的意義。演算法只是一種工具,而非預言機。
Comments
No comments yet. Be the first to share a thought.
Leave a comment