एक बच्चा जिसने कभी ज़ेबरा नहीं देखा हो, उसे यह बताने पर भी कि यह धारियों वाले घोड़े जैसा दिखता है, वह उसे पहचान सकता है। ज़ीरो-शॉट लर्निंग मशीनों से कुछ ऐसा ही करने को कहती है: उन्हें उन वर्गों या कार्यों को संभालना होता है जिन पर उन्हें कभी प्रशिक्षित नहीं किया गया है, सहायक जानकारी जैसे कि विशेषता विवरण या अर्थपूर्ण संबंध का उपयोग करके।
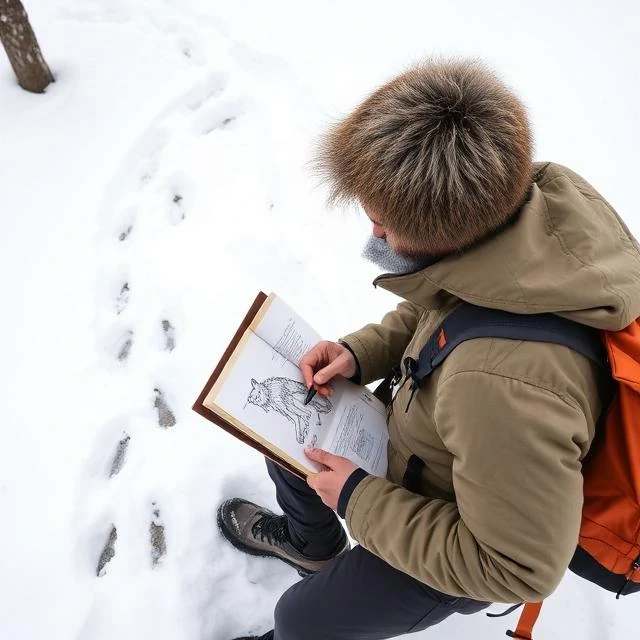
इमेज क्लासिफिकेशन में, एक ज़ीरो-शॉट मॉडल को बिल्लियों और कुत्तों पर प्रशिक्षित किया जा सकता है, लेकिन उसे भेड़िये की पहचान करने के लिए कहा जा सकता है। यदि मॉडल ने "फर होना", "नुकीले कान होना" और "झुंड में रहना" जैसे गुण सीख लिए हैं, तो वह बिना कभी भेड़िये को देखे भी, इन गुणों को मिलाकर भेड़िये का प्रतिनिधित्व कर सकता है। देखे गए और अनदेखे वर्गों के बीच का सेतु आमतौर पर एक साझा सिमेंटिक स्पेस होता है, जो अक्सर टेक्स्ट विवरण या नॉलेज ग्राफ़ से निर्मित होता है।
यह क्यों मायने रखती है
- नई श्रेणियां लगातार सामने आती रहती हैं और उन्हें लेबल करना धीमा होता है।
- कुछ प्रजातियाँ दुर्लभ हैं या बड़े पैमाने पर उनका संग्रह करना असंभव है।
- अब बड़े भाषा मॉडल केवल एक संकेत से ही कई कार्यों को बिना किसी पूर्व संकेत के पूरा कर लेते हैं।
- इससे नए डोमेन में मॉडल को तैनात करने की लागत कम हो जाती है।
अधिकांश मानकों पर ज़ीरो-शॉट प्रदर्शन अभी भी सुपरवाइज्ड लर्निंग से पीछे है। सहायक विवरण विस्तृत होने और अनदेखे वर्ग प्रशिक्षण वितरण के करीब होने पर यह अंतर कम हो जाता है। जब वे बहुत दूर होते हैं, तो मॉडल का अनुमान गलत और अक्सर आत्मविश्वासपूर्ण होता है।
Comments (2)
Leave a comment