即使從未見過斑馬的孩子,只要被告知斑馬長得像有條紋的馬,也能認出它來。零樣本學習要求機器做類似的事情:利用屬性描述或語義關係等輔助訊息,處理它們從未接受過訓練的類別或任務。
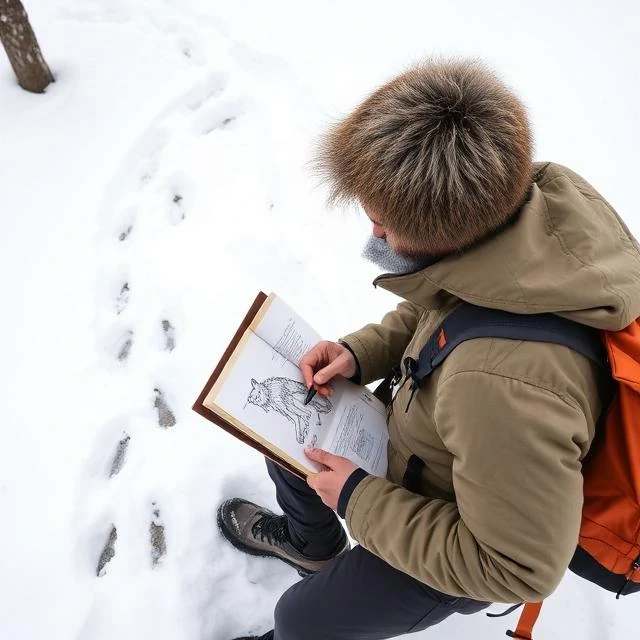
在圖像分類中,一個零樣本模型可能只訓練過貓和狗的圖像,但卻被要求識別狼。如果模型已經學習了「有毛」、「有尖耳朵」和「群居」等屬性,它就可以將這些屬性組合成狼的特徵,而無需實際觀察過狼。連接已見類別和未見類別的橋樑通常是共享的語意空間,這個空間通常由文字描述或知識圖譜建構而成。
為什麼這很重要
- 新類別層出不窮,給它們貼標籤卻很慢。
- 有些類別的樣本稀少,或根本無法大規模採集。
- 現在,大型語言模型僅憑提示就能執行許多零樣本任務。
- 它降低了將模型部署到新領域的成本。
在大多數基準測試中,零樣本學習的表現仍然落後於監督學習。當輔助描述資訊豐富且未見過的類別與訓練分佈接近時,這種差距會縮小。當兩者相距甚遠時,模型的預測結果往往不準確,而且常常過於自信。
Comments (2)
Leave a comment