Ein Kind, das noch nie ein Zebra gesehen hat, erkennt es trotzdem, wenn man ihm erklärt, dass es wie ein Pferd mit Streifen aussieht. Zero-Shot-Learning fordert Maschinen auf, etwas Ähnliches zu tun: Klassen oder Aufgaben zu bewältigen, für die sie nie trainiert wurden, mithilfe von Zusatzinformationen wie Attributbeschreibungen oder semantischen Beziehungen.
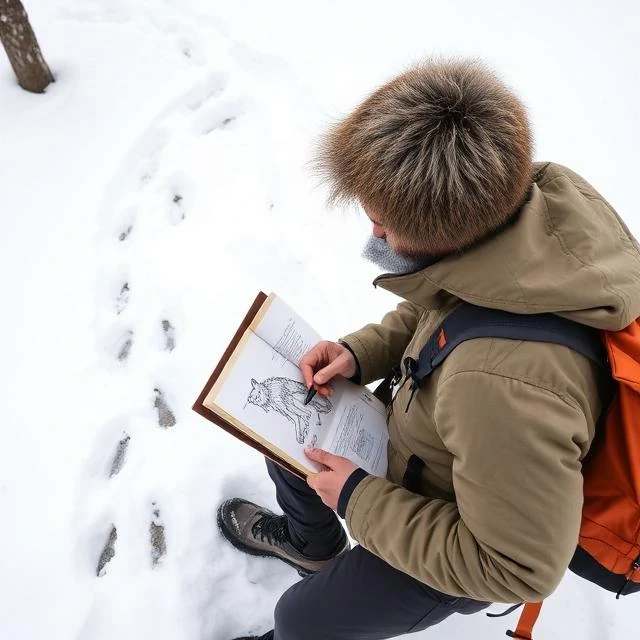
Bei der Bildklassifizierung könnte ein Zero-Shot-Modell mit Katzen- und Hundedaten trainiert und anschließend aufgefordert werden, einen Wolf zu identifizieren. Hat das Modell Attribute wie „hat Fell“, „hat spitze Ohren“ und „lebt im Rudel“, kann es diese zu einer Repräsentation des Wolfs zusammensetzen, ohne jemals einen gesehen zu haben. Die Brücke zwischen bekannten und unbekannten Klassen bildet üblicherweise ein gemeinsamer semantischer Raum, der häufig aus Textbeschreibungen oder Wissensgraphen erstellt wird.
Warum es wichtig ist
- Ständig entstehen neue Kategorien, und deren Benennung ist langsam.
- Manche Klassen sind selten oder unmöglich in großem Umfang zu sammeln.
- Große Sprachmodelle erledigen mittlerweile viele Aufgaben ohne vorherige Eingabe eines Prompts.
- Es reduziert die Kosten für die Einführung eines Modells in neuen Domänen.
Die Leistung von Zero-Shot-Methoden hinkt bei den meisten Benchmarks weiterhin hinter überwachtem Lernen her. Der Unterschied verringert sich, wenn die zusätzlichen Beschreibungen umfangreich sind und die unbekannten Klassen der Verteilung der Trainingsdaten nahekommen. Sind sie weit voneinander entfernt, trifft das Modell schlechte und oft zu selbstsichere Vorhersagen.
Comments (2)
Leave a comment