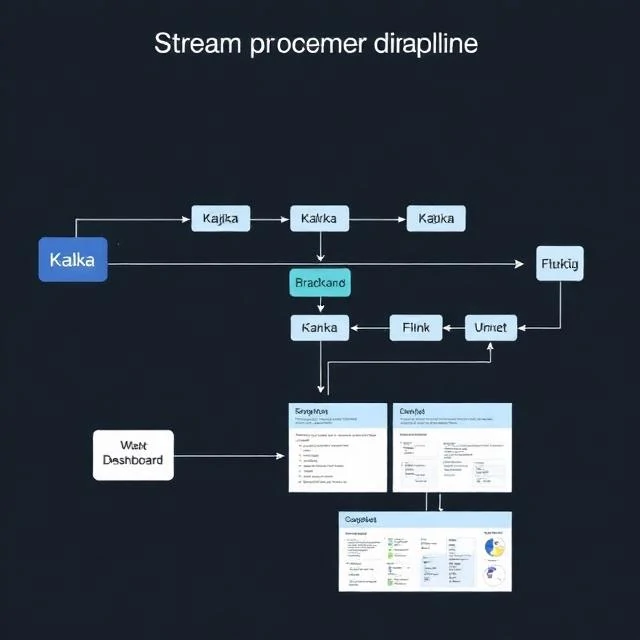
Przetwarzanie strumieniowe przetwarza dane w sposób ciągły w miarę ich napływania. Zamiast gromadzić dane w partiach i przetwarzać je w określonych odstępach czasu, procesory strumieniowe analizują każde zdarzenie w trakcie jego przepływu przez system. Transakcja kartą kredytową jest oceniana pod kątem oszustwa w milisekundach. Odczyt z czujnika uruchamia alert po przekroczeniu progu. Strumień kliknięć aktualizuje model rekomendacji w czasie rzeczywistym. Przetwarzanie odbywa się w ruchu, a nie w spoczynku.
Architektura różni się od przetwarzania wsadowego. Dane docierają przez kolejki komunikatów, takie jak Kafka lub Kinesis. Procesory strumieniowe, takie jak Flink, Spark Streaming lub Kafka Streams, pobierają zdarzenia, stosują transformacje i emitują wyniki. System musi obsługiwać zdarzenia przychodzące z opóźnieniem, dane w nieprawidłowej kolejności i semantykę dokładnie raz. To trudne problemy. Zdarzenia opóźnione wymagają znaków wodnych, aby określić, kiedy okno czasowe jest zakończone. Zdarzenia w nieprawidłowej kolejności wymagają buforowania i zmiany kolejności. Przetwarzanie dokładnie raz wymaga koordynacji między źródłem, procesorem i odbiorcą. Uzyskanie prawidłowych wyników jest skomplikowane. Gdy są one nieprawidłowe, wyniki są niespójne lub zduplikowane. Przetwarzanie strumieniowe jest wydajne w przypadkach użycia wymagających natychmiastowego wglądu. Jest to jednak przesada w przypadku raportów nocnych. Wybór między przetwarzaniem wsadowym a strumieniowym zależy od wymagań dotyczących opóźnienia. Jeśli minuty lub godziny są akceptowalne, przetwarzanie wsadowe jest prostsze i tańsze. Jeśli sekundy mają znaczenie, przetwarzanie strumieniowe jest jedyną opcją.
Charakterystyka przetwarzania strumieniowego
- Ciągły — przetwarza zdarzenia w miarę ich pojawiania się
- Niskie opóźnienie — od milisekund do sekund
- Stanowy — utrzymuje stan między zdarzeniami
- Złożony — obsługuje dane spóźnione i nieuporządkowane
- Skalowalny — rozkłada się na wiele węzłów
Przetwarzanie strumieniowe to przetwarzanie wsadowe odwrócone do góry nogami. Zamiast czekać na zgromadzenie danych, przetwarza każde zdarzenie w momencie jego wystąpienia.
Comments
No comments yet. Be the first to share a thought.
Leave a comment