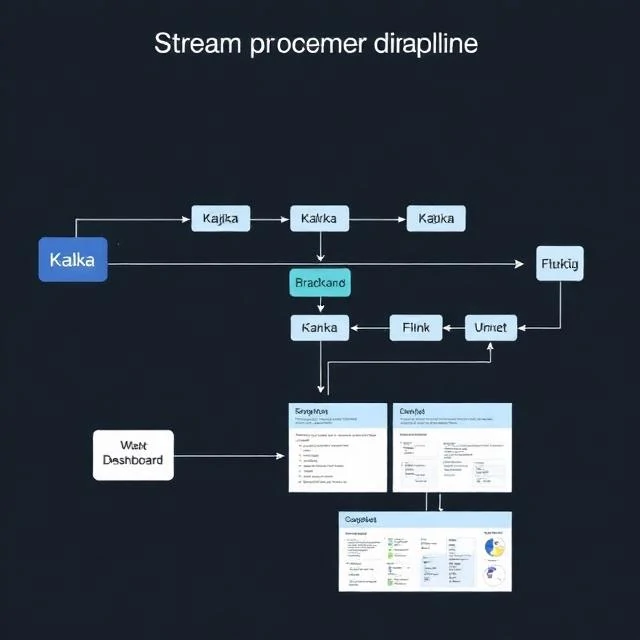
El procesamiento de flujo gestiona los datos de forma continua a medida que llegan. En lugar de recopilar los datos en lotes y procesarlos a intervalos, los procesadores de flujo analizan cada evento a medida que fluye por el sistema. Una transacción con tarjeta de crédito se evalúa para detectar fraude en milisegundos. La lectura de un sensor activa una alerta cuando supera un umbral. Un flujo de clics actualiza un modelo de recomendación en tiempo real. El procesamiento se realiza en movimiento, no en reposo.
La arquitectura difiere de la del procesamiento por lotes. Los datos llegan a través de colas de mensajes como Kafka o Kinesis. Los procesadores de flujo como Flink, Spark Streaming o Kafka Streams consumen los eventos, aplican transformaciones y emiten resultados. El sistema debe manejar eventos que llegan tarde, datos fuera de orden y semántica de procesamiento único. Estos son problemas difíciles. Los eventos tardíos requieren marcas de agua para determinar cuándo se completa una ventana de tiempo. Los eventos fuera de orden requieren almacenamiento en búfer y reordenamiento. El procesamiento de procesamiento único requiere coordinación entre la fuente, el procesador y el destino. Lograr que esto funcione correctamente es complejo. Cuando falla, los resultados son inconsistentes o duplicados. El procesamiento de flujo es potente para casos de uso que necesitan información inmediata. Es excesivo para informes nocturnos. La elección entre procesamiento por lotes y de flujo depende del requisito de latencia. Si los minutos u horas son aceptables, el procesamiento por lotes es más simple y económico. Si los segundos importan, el procesamiento de flujo es la única opción.
Características del procesamiento de flujo
- Continuo: procesa los eventos a medida que llegan.
- Baja latencia: de milisegundos a segundos.
- Con estado: mantiene el estado entre eventos
- Complejo: maneja datos tardíos y fuera de orden.
- Escalable: se distribuye entre muchos nodos.
El procesamiento de flujos de datos es como el procesamiento por lotes, pero a la inversa. En lugar de esperar a que se acumulen los datos, actúa sobre cada evento a medida que aparece.
Comments
No comments yet. Be the first to share a thought.
Leave a comment