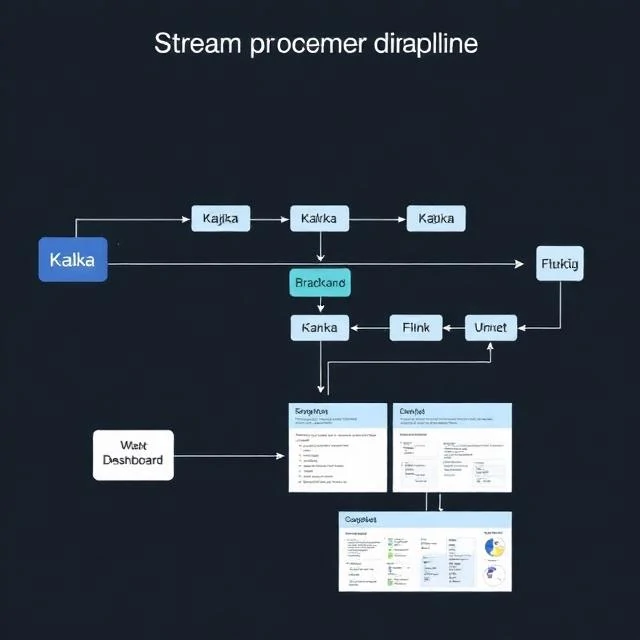
تعالج معالجة البيانات المتدفقة البيانات بشكل مستمر فور وصولها. فبدلاً من تجميع البيانات في دفعات ومعالجتها على فترات، تحلل معالجات البيانات المتدفقة كل حدث أثناء مروره عبر النظام. يتم تقييم عملية بطاقة الائتمان للكشف عن الاحتيال في أجزاء من الثانية. ويؤدي تجاوز قراءة المستشعر لعتبة معينة إلى إطلاق تنبيه. كما يقوم سجل نقرات المستخدمين بتحديث نموذج التوصيات في الوقت الفعلي. تتم المعالجة أثناء الحركة، وليس في حالة سكون.
يختلف تصميم النظام عن نظام المعالجة الدفعية. تصل البيانات عبر قوائم انتظار الرسائل مثل Kafka أو Kinesis. تستهلك معالجات التدفق مثل Flink أو Spark Streaming أو Kafka Streams الأحداث، وتُجري عليها التحويلات، ثم تُصدر النتائج. يجب أن يتعامل النظام مع الأحداث المتأخرة، والبيانات غير المرتبة، ودلالات المعالجة لمرة واحدة فقط. هذه تحديات معقدة. تتطلب الأحداث المتأخرة علامات مائية لتحديد اكتمال نافذة زمنية. تتطلب الأحداث غير المرتبة التخزين المؤقت وإعادة الترتيب. تتطلب المعالجة لمرة واحدة فقط التنسيق بين المصدر والمعالج والمستقبل. يُعدّ ضبط هذه العمليات بدقة أمرًا معقدًا. عند حدوث خطأ، تكون النتائج غير متناسقة أو مكررة. تُعدّ معالجة التدفق فعّالة لحالات الاستخدام التي تتطلب رؤية فورية. لكنها غير مناسبة للتقارير الليلية. يعتمد الاختيار بين المعالجة الدفعية والتدفق على متطلبات زمن الاستجابة. إذا كانت الدقائق أو الساعات مقبولة، فإن المعالجة الدفعية أبسط وأقل تكلفة. أما إذا كانت الثواني مهمة، فإن معالجة التدفق هي الخيار الوحيد.
خصائص معالجة البيانات المتدفقة
- مستمر - يعالج الأحداث فور وصولها
- زمن استجابة منخفض - من أجزاء من الثانية إلى ثوانٍ
- يحتفظ بالحالة — يحافظ على الحالة عبر الأحداث
- معقد — يتعامل مع البيانات المتأخرة وغير المرتبة
- قابل للتوسع - يتم توزيعه عبر العديد من العقد
معالجة البيانات المتدفقة هي معالجة دفعية معكوسة. فبدلاً من انتظار تراكم البيانات، تعالج كل حدث فور ظهوره.
Comments
No comments yet. Be the first to share a thought.
Leave a comment