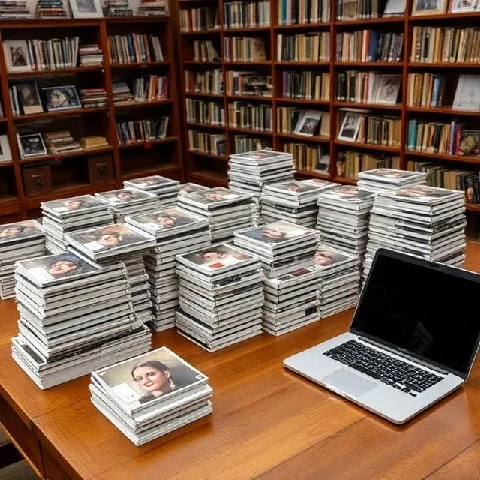
Setiap model adalah cerminan terkompresi dari apa yang dimasukkan ke dalamnya. Data pelatihan adalah "makanan" tersebut: kumpulan contoh yang dipelajari oleh sistem pembelajaran mesin sebelum diminta untuk melakukan sesuatu yang berguna. Model pengenalan wajah mungkin belajar dari jutaan potret berlabel. Mesin catur belajar dari jutaan permainan. Pengklasifikasi medis belajar dari hasil pemindaian yang dianotasi oleh ahli radiologi.
Volume memang membantu, tetapi komposisi jauh lebih penting. Jika potret didominasi oleh pria kulit putih, model tersebut akan gagal pada kulit yang lebih gelap dan wanita. Jika data permainan hanya berasal dari pemain amatir, mesin akan mencapai titik jenuh. Para peneliti menyebut ini pergeseran distribusi, dan ini adalah salah satu alasan paling umum mengapa model yang tampak brilian di laboratorium mengalami kesulitan di dunia nyata.
Pertimbangan praktis
- Kualitas label: anotasi yang bising atau bias merusak model.
- Persetujuan dan perizinan: data yang diambil dari web mungkin mengandung risiko hukum.
- Privasi: informasi pribadi seringkali harus dihapus atau dianonimkan.
- Representasi: kelompok langka membutuhkan pengambilan sampel berlebih secara sengaja.
Pembersihan dan kurasi data biasanya menghabiskan 60 hingga 80 persen waktu proyek pembelajaran mesin. Bagian yang menarik adalah arsitekturnya; bagian yang menentukan adalah kumpulan datanya.
Comments
No comments yet. Be the first to share a thought.
Leave a comment