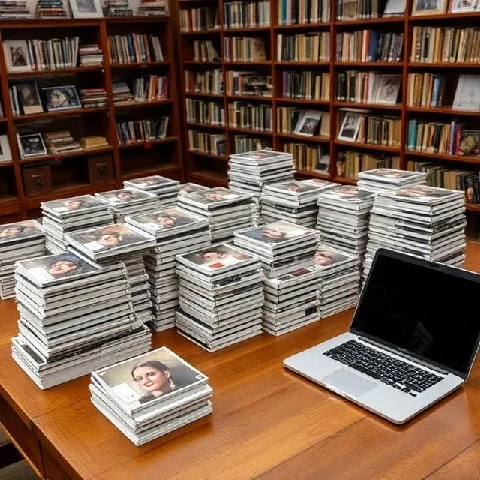
Κάθε μοντέλο είναι μια συμπιεσμένη αντανάκλαση αυτού που του δόθηκε. Τα δεδομένα εκπαίδευσης είναι αυτή η δίαιτα: η συλλογή παραδειγμάτων που μελετά ένα σύστημα μηχανικής μάθησης πριν του ζητηθεί να κάνει οτιδήποτε χρήσιμο. Ένα μοντέλο αναγνώρισης προσώπου μπορεί να μάθει από εκατομμύρια πορτρέτα με ετικέτες. Μια μηχανή σκακιού μαθαίνει από εκατομμύρια παιχνίδια. Ένας ιατρικός ταξινομητής μαθαίνει από σαρώσεις που έχουν σχολιαστεί από ακτινολόγους.
Ο όγκος βοηθάει, αλλά η σύνθεση έχει μεγαλύτερη σημασία. Αν τα πορτρέτα είναι ασύμμετρα λευκά και ανδρικά, το μοντέλο θα αποτύχει σε πιο σκούρο δέρμα και γυναίκες. Αν τα δεδομένα του παιχνιδιού προέρχονται μόνο από ερασιτέχνες παίκτες, η μηχανή θα σταθεροποιηθεί. Οι ερευνητές ονομάζουν αυτή τη μετατόπιση κατανομής και είναι ένας από τους πιο συνηθισμένους λόγους που ένα μοντέλο που φαίνεται εξαιρετικό στο εργαστήριο σκοντάφτει στην άγρια φύση.
Πρακτικές ανησυχίες
- Ποιότητα ετικέτας: οι θορυβώδεις ή μεροληπτικές σχολιασμοί δηλητηριάζουν το μοντέλο
- Συγκατάθεση και αδειοδότηση: τα δεδομένα που συλλέγονται από τον ιστό ενδέχεται να ενέχουν νομικό κίνδυνο
- Απόρρητο: τα προσωπικά στοιχεία πρέπει συχνά να διαγράφονται ή να ανωνυμοποιούνται
- Αναπαράσταση: οι σπάνιες ομάδες χρειάζονται σκόπιμη υπερδειγματοληψία
Ο καθαρισμός και η επιμέλεια δεδομένων συνήθως καταναλώνει το 60 έως 80 τοις εκατό του χρόνου ενός έργου μηχανικής μάθησης. Το πιο εντυπωσιακό κομμάτι είναι η αρχιτεκτονική, ενώ το πιο καθοριστικό είναι το σύνολο δεδομένων.
Comments
No comments yet. Be the first to share a thought.
Leave a comment