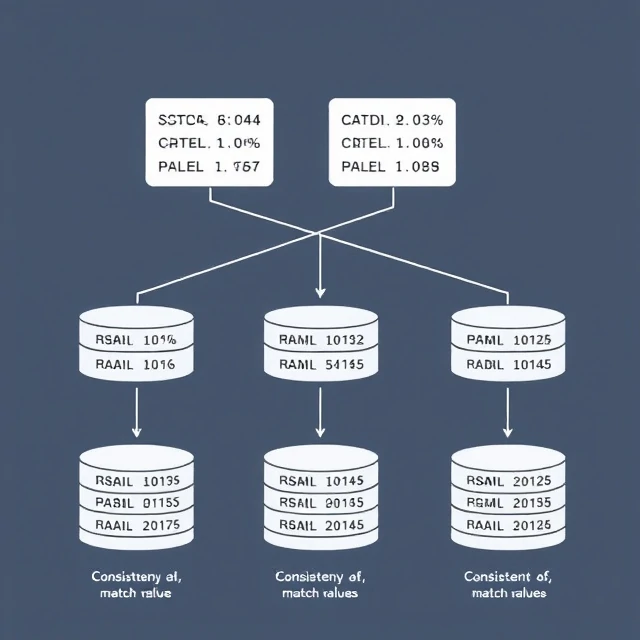
数据一致性意味着相同的数据在任何地方看起来都一样。例如,账单系统中的客户地址必须与发货系统中的地址一致。仓库中的库存数量必须与网站上的库存数量一致。如果系统之间存在差异,就会导致决策错误。订单可能会被寄送到旧地址,客户可能会购买到缺货的产品。对于相互依赖的系统而言,数据一致性至关重要。
分布式系统难以保证数据一致性。跨多个服务器复制的数据可能会失去同步。网络分区会将一个区域与其他区域隔离。两个区域都接受写入操作。当分区恢复时,数据就会发生冲突。CAP 定理指出,一致性、可用性和分区容错性可以兼得,但无法同时实现这三者。大多数分布式数据库选择可用性和最终一致性。这意味着数据会随着时间的推移而趋于一致,但在一段时间内,不同节点可能会看到不同的值。强一致性需要协调,这会增加延迟。具体选择取决于应用程序。银行账簿需要强一致性。社交媒体信息流可以容忍最终一致性。正确的答案并非放之四海而皆准。它取决于数据不一致时哪些环节会受到影响。
一致性模型
- 强——所有节点立即都能看到相同的数据
- 最终——节点会随着时间推移而收敛
- 因果关系——相关操作按顺序进行。
- 阅读自己写的内容——您可以立即看到自己的更新。
一致性是一个连续谱。问题在于应用程序在崩溃之前能够容忍多大的不一致性。
Comments
No comments yet. Be the first to share a thought.
Leave a comment