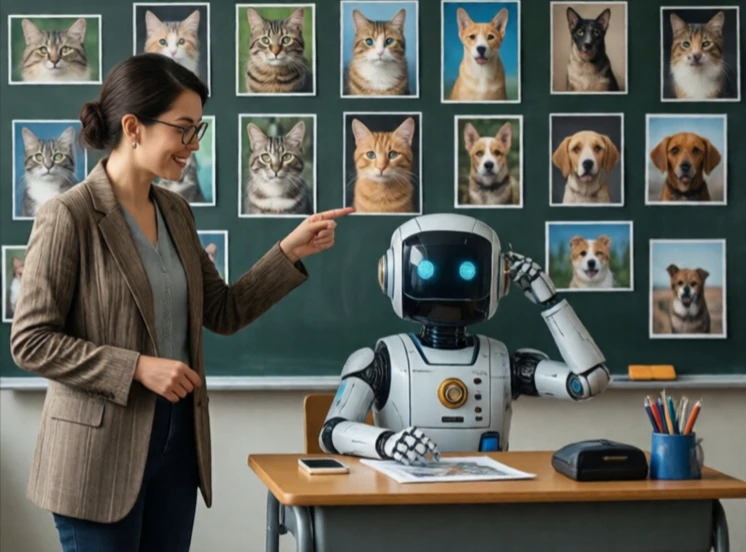
Bir spam filtresi, daha önce "spam" veya "spam değil" olarak işaretlenmiş binlerce mesajı gördüğü için bir e-postayı önemsiz olarak işaretler. Bu, minyatür bir denetimli öğrenme örneğidir: bir model, doğru cevabın bilindiği örnekleri kullanarak girdilerden çıktılara bir eşleme öğrenir. Her eğitim çifti bir etiket taşır ve algoritma, tahminleri yeni verilere genelleme yapabilecek kadar bu etiketlerle yakından eşleşene kadar iç parametrelerini ayarlar.
Bu yaklaşım iki ana kategoriye ayrılıyor. Sınıflandırma, bir tümörün iyi huylu mu yoksa kötü huylu mu olduğu gibi bir kategoriyi tahmin eder. Regresyon ise yarının sıcaklığı veya ev fiyatı gibi bir sayıyı tahmin eder. Her ikisi de aynı temel döngüye dayanır: bir tahmin yapın, hatayı etikete göre ölçün ve bu hatayı azaltmak için ağırlıkları ayarlayın.
Ortak algoritmalar
- Basit ve yorumlanabilir temel değerler için doğrusal ve lojistik regresyon
- Tablo verileri için karar ağaçları ve rastgele ormanlar
- Kenar boşluğuna dayalı sınıflandırma için destek vektör makineleri
- Görüntüler, konuşma ve dil için sinir ağları
Etiketleme maliyetli ve zaman alıcıdır. 10.000 taramayı etiketleyen bir radyolog pahalıdır; duygu analizini etiketleyen bir grup çalışan yavaş ve gürültülüdür. Bu maliyet, denetimsiz ve yarı denetimli yöntemlerin bu kadar çok ilgi çekmesinin ana nedenidir. Ancak, temiz etiketler bol miktarda mevcut olduğunda, denetimli öğrenme en güvenilir araç olmaya devam etmektedir.
Comments
No comments yet. Be the first to share a thought.
Leave a comment