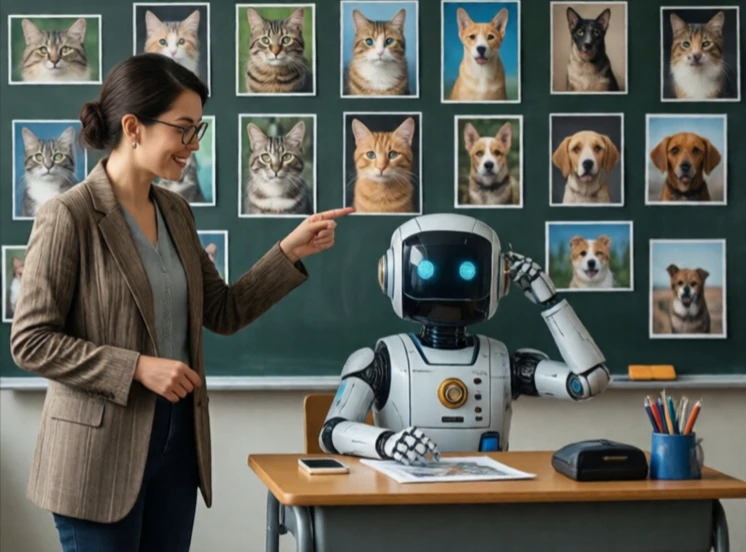
Filtr spamu oznacza wiadomość e-mail jako niechcianą, ponieważ tysiące wiadomości zostało już oznaczonych jako „spam” lub „nie spam”. To właśnie jest uczenie nadzorowane w miniaturze: model uczy się mapowania danych wejściowych na dane wyjściowe, korzystając z przykładów, w których znana jest poprawna odpowiedź. Każda para treningowa ma przypisaną etykietę, a algorytm dostosowuje swoje parametry wewnętrzne, aż jego przewidywania będą wystarczająco zbliżone do tych etykiet, aby można je było uogólnić na nowe dane.
Podejście to dzieli się na dwie szerokie rodziny. Klasyfikacja przewiduje kategorię, na przykład to, czy guz jest łagodny, czy złośliwy. Regresja przewiduje wartość liczbową, na przykład jutrzejszą temperaturę lub cenę domu. Obie metody opierają się na tej samej pętli: generowaniu prognozy, mierzeniu błędu względem etykiety i modyfikowaniu wag w celu zmniejszenia tego błędu.
Typowe algorytmy
- Regresja liniowa i logistyczna dla prostych, interpretowalnych linii bazowych
- Drzewa decyzyjne i lasy losowe dla danych tabelarycznych
- Maszyny wektorów nośnych do klasyfikacji opartej na marginesach
- Sieci neuronowe dla obrazów, mowy i języka
Etykiety kosztują pieniądze i czas. Radiolog, który opatruje adnotacjami 10 000 skanów, jest drogi; grupa pracowników zajmująca się etykietowaniem sentymentów jest powolna i generuje zakłócenia. Ten koszt jest głównym powodem, dla którego metody nienadzorowane i półnadzorowane cieszą się tak dużym zainteresowaniem. Jednak gdy czyste etykiety są powszechne, uczenie nadzorowane pozostaje najbardziej niezawodnym narzędziem.
Comments
No comments yet. Be the first to share a thought.
Leave a comment