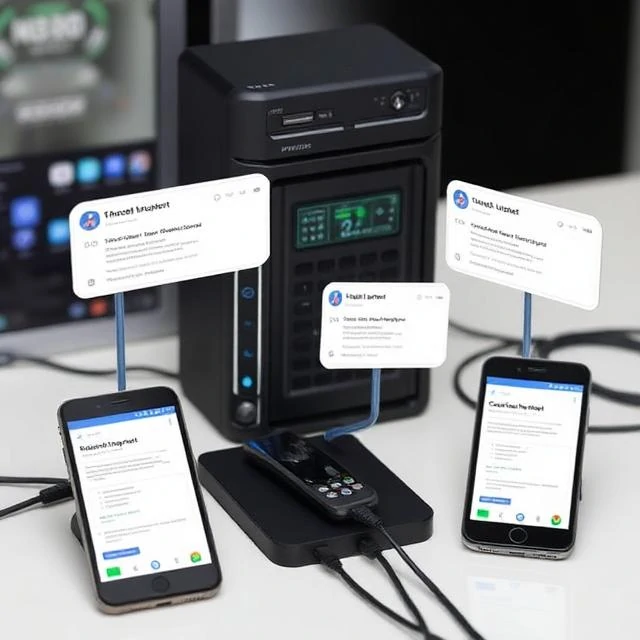
Data forblir der de er. Federert læring trener modeller på tvers av mange enheter uten å sentralisere rådata. Hver enhet beregner oppdateringer på lokale data, sender bare disse oppdateringene til en server, og serveren aggregerer dem til en delt modell.
Tilnærmingen passer situasjoner der personvern eller båndbredde gjør sentralisering upraktisk. Tastaturer lærer skrivemønstre uten å sende tastetrykk. Sykehus trener diagnostiske modeller uten å dele pasientjournaler.
Kjernemekanikk
- Lokal opplæring på hver enhet
- Gradient- eller modelloppdateringer sendt til en server
- Aggregering til en oppdatert global modell
- Distribusjon tilbake til enheter for neste runde
Utfordringene vedvarer. Enheter har ulik datadistribusjon, tilkoblingshastighet og tilgjengelighet. Kommunikasjonskostnadene er betydelige, og oppdateringer kan lekke informasjon hvis de ikke beskyttes nøye. Sikker aggregering og differensiell personvern gir sikkerhetstiltak til en ekstra kostnad.
Comments
No comments yet. Be the first to share a thought.
Leave a comment